Ontologie d'entreprise : pourquoi définition et runtime doivent être ouverts
Ontology MCP est passé en GA en juin 2026 : les éditeurs ont eux-mêmes confié l’interface agent à un protocole ouvert. La définition suit. Seul le runtime est resté fermé — or la portabilité y habite.

En bref : cet article soutenait en juin 2026 que la définition typée d’application et le runtime qui l’exécute devaient tous deux être ouverts. Depuis, le secteur en a concédé une partie de lui-même. L’Ontology MCP de Palantir est devenu généralement disponible la semaine du 16 juin 2026 — quatre jours après la publication de ce texte — rendant les objets et les actions d’une ontologie appelables par n’importe quel agent via un protocole ouvert ; en août, Palantir a commencé à déplacer les définitions d’ontologie vers un dépôt versionné. La portabilité se joue sur trois couches — interface, définition, runtime — et 2026 a ouvert la première, commencé à ouvrir la deuxième, et laissé la troisième exactement où elle était. Le runtime est la dernière couche fermée, et c’est la moitié de cet argument qui mérite encore d’être débattue.
Commençons par une histoire que vous avez probablement déjà vue se dérouler.
Une entreprise lance un projet « assistant IA ». Première semaine : la démo est éblouissante. Quelqu’un exporte une copie des données clients, la donne à un modèle, et celui-ci sait vraiment répondre à « quels comptes de la région Est risquent de ne pas renouveler ? ». La direction valide aussitôt un pilote élargi.
Mois trois : il faut connecter les données de production. L’équipe sécurité entre dans la pièce et pose trois questions :
- Quelles données l’IA peut-elle voir ? Si le commercial A demande « le classement des performances de toute l’entreprise », va-t-elle lire à voix haute les commissions des autres ?
- Elle va exécuter des actions — modifier une remise, envoyer un contrat. Avec les permissions de qui ? Et quand quelque chose tourne mal, qui est responsable ?
- Quand l’audit demandera « qui a approuvé cette remise », où est l’enregistrement de la partie effectuée par l’IA ?
L’équipe projet n’a pas de réponses. Non par négligence — mais parce que l’architecture ne contient aucune couche capable de répondre à ces questions. Les données sont éparpillées dans une douzaine de systèmes. Les permissions vivent dans le code de chaque application. La règle d’« approbation des remises » existe surtout dans la tête d’un employé chevronné. L’IA contemple des tables brutes et des endpoints bruts, et aucune intelligence ne peut lire les règles d’une entreprise là où elles n’ont jamais été écrites.
Mois neuf : le pilote s’éteint en silence. Le modèle n’a pas perdu en capacité. Il a perdu parce que personne n’a voulu signer.
L’industrie a un nom pour ce qui manquait : une ontologie — une couche sémantique structurée et lisible par les machines, qui définit explicitement quels objets métier existent, comment ils sont liés, qui a le droit de faire quoi, et où chaque action est enregistrée.
Ce que Palantir a vu juste
L’entreprise qui a transformé l’ontologie de concept de recherche en fait commercial s’appelle Palantir. Cela vaut la peine de regarder honnêtement pourquoi elle a réussi — plus le regard est juste, plus la question qui suit est tranchante.
Palantir Foundry fait deux choses essentielles. Premièrement, il intègre les données éparpillées d’une entreprise dans une couche d’ontologie unifiée : clients, équipements et commandes cessent d’être des dizaines de tables pour devenir des objets métier typés, avec relations et propriétés. Deuxièmement, il canalise toute opération d’écriture à travers des Actions gouvernées — chacune validée, soumise aux permissions et entièrement auditée. Depuis 2023, AIP pointe cette architecture droit sur les grands modèles de langage : le LLM ne touche jamais la base de données ; il ne peut qu’appeler des outils gouvernés exposés par la couche d’ontologie. Les modèles se remplacent. La frontière reste.
Pourquoi est-ce cher ? Parce que le problème résolu est réellement cher. Démêler vingt ans de systèmes hérités pour en faire une ontologie propre exige que les Forward Deployed Engineers de Palantir avancent système par système, concept par concept — de l’ingénierie à forte intensité humaine au sens le plus littéral. Ses clients sont les gouvernements, la défense, la banque, l’énergie — pour qui « chaque pas de l’IA dans les permissions, chaque pas enregistré » est une exigence dure, avec le budget assorti. Les contrats démarrent en millions, et les clients renouvellent — parce que cela répond vraiment aux trois questions qui comptent le plus pour un RSSI. Les trois mêmes que dans l’histoire d’ouverture.
Le succès de Palantir ne prouve pas seulement une machine commerciale. Il prouve un jugement d’architecture : pour que l’IA entre dans l’entreprise, une couche sémantique métier gouvernée doit d’abord exister. Ce jugement n’a plus besoin d’être défendu.
Ce qu’il faut repenser, c’est la question suivante : sous quelle forme cette couche doit-elle exister ? Car certaines choses sont en train de changer.
Le logiciel est de plus en plus écrit par l’IA
Le premier changement est le plus visible : les applications elles-mêmes sont de plus en plus écrites par l’IA.
« Construire un système sur mesure d’approbation des notes de frais pour une équipe de 50 personnes » était économiquement absurde — le coût de développement dépassait la douleur. Aujourd’hui, un agent IA le livre en un après-midi. Le logiciel métier sur mesure passe du bien rare au produit courant, et la demande totale va exploser.
Remarquez où elle explose : dans la longue traîne. Dans des équipes qui n’apparaîtront jamais sur la liste de prospects d’aucun éditeur enterprise — pas de processus achats, pas de budget d’intégration, pas de comités de POC. Elles disent simplement à un agent « construis quelque chose qui marche », et l’utilisent le jour même.
Un modèle qui repose sur des ingénieurs détachés et des contrats à millions ne peut structurellement pas atteindre ce marché. Ce n’est pas une critique ; ce sont simplement deux marchés différents. Mais chaque système de ce nouveau marché percutera les trois mêmes questions de sécurité qu’au début — sauf qu’au moment du choc, aucun ingénieur détaché ne se tiendra à côté.
Le prochain à choisir la technologie, c’est un agent
Le deuxième changement est plus discret mais plus profond : l’acte même de choisir une technologie passe des humains à l’IA.
Demandez aujourd’hui à un agent de « construire un système de gestion clients » : il choisira très probablement Next.js et Postgres. Pourquoi ? Personne n’a acheté de publicité dans sa tête. Ces technologies sont ouvertes, abondamment documentées et massivement présentes dans ses données d’entraînement. L’agent a vu des centaines de milliers d’usages et connaît chaque nid-de-poule.
Cela crée quelque chose qui n’existait pas avant : pour la technologie destinée aux développeurs, le texte public du protocole et le code open source sont désormais le canal de distribution lui-même. Plus un protocole est ouvert — plus on en discute, plus il y a de code à apprendre —, mieux la génération suivante de modèles le comprend, et plus les agents le choisissent par défaut. La boucle s’auto-alimente.
Une plateforme fermée dispose de deux sorties. La coûteuse : ouvrir le format lui-même, pour que les modèles l’apprennent et que les agents s’en saisissent sans qu’on le leur souffle. La bon marché : garder le format fermé et adopter un protocole ouvert en bordure — les agents peuvent alors appeler la plateforme même s’ils restent incapables de l’apprendre.
À sa première parution, cet article affirmait qu’une plateforme fermée ne pouvait tout simplement pas entrer dans la boucle. En moins d’une semaine, c’était trop fort : les acteurs en place ont pris la sortie bon marché, et cela a fonctionné. Ce qui subsiste est l’affirmation plus étroite, et c’est celle qui compte : une interface qu’un agent peut appeler n’est pas une définition dont un agent peut apprendre, et aucune des deux n’est un runtime que vous pouvez emporter. Ce que les acteurs en place ont fait ensuite — et la seule chose qu’ils n’ont pas faite — se trouve plus bas.
Attendez — les plateformes fermées n’ont-elles pas déjà gagné ?
À ce stade, une objection intelligente devrait avoir surgi : l’ouverture ne gagne pas toujours. L’ère du cloud a été gagnée par AWS. Le mobile, par l’iPhone. Tous deux fermés.
L’objection mérite une réponse sérieuse, car y répondre révèle le véritable motif.
Regardez comment AWS gagne de l’argent : il héberge Linux, Kubernetes, Postgres — des standards ouverts de bout en bout. L’iPhone est fermé, mais chaque paquet qu’il envoie circule sur TCP/IP et HTTP. Remontez plus loin : les éditeurs de bases de données se sont entretués pendant que SQL, le langage lui-même, restait public ; les guerres de l’orchestration de conteneurs se sont terminées avec tout le monde sur le même format ouvert d’images OCI.
Le motif est remarquablement constant : le socle portable dont dépend tout un écosystème finit par devenir ouvert — la définition comme le runtime de base qui l’interprète. Les fournisseurs conservent des revenus récurrents, mais grâce à l’expérience de production opérée : hébergement, mises à niveau, sécurité, performance, support et responsabilité. AWS en est la meilleure preuve. Linux, Kubernetes et Postgres restent ouverts ; AWS facture leur exploitation fiable.
Une couche sémantique métier est exactement ce type de socle. Vos applications, vos agents et vos systèmes d’audit dépendront du modèle d’objets, des règles de permissions, des circuits d’approbation et de la sémantique du runtime qui les applique. Plus il y a de dépendances, moins l’une ou l’autre moitié doit vivre dans la plateforme d’un fournisseur. Les définitions doivent être des fichiers lisibles et versionnés dans votre dépôt ; un runtime compatible doit être auto-hébergeable et remplaçable. Un fichier ouvert que seul un moteur payant peut exécuter n’est pas vraiment portable.
Les entreprises ont passé vingt ans à libérer leurs données d’un système fermé après l’autre. Elles ne devraient pas passer l’ère de l’IA à enfermer de nouveau quelque chose d’encore plus fondamental : la définition même du métier.
Ontology MCP a ouvert l’interface. Le runtime est resté fermé.
Ce schéma a été mis à l’épreuve presque immédiatement, et le résultat constitue une meilleure preuve que ne l’était la prédiction.
Quatre jours après la parution de cet article, l’Ontology MCP de Palantir est devenu généralement disponible sur les enrollments Foundry, à partir de la semaine du 16 juin 2026 (documentation de Palantir). Les types d’objets, les types d’actions et les fonctions sont projetés en outils Model Context Protocol : tout agent compatible MCP peut lire l’ontologie et déclencher ses processus sans code d’intégration écrit pour chaque framework. Microsoft présente la même interface en préversion dans Fabric IQ.
Puis, en août, Palantir a livré en bêta l’ontologie sous forme de code : types d’objets, liens, interfaces et actions déclarés en TypeScript dans un monorepo, ces définitions de code faisant foi.
Mettez les deux mouvements bout à bout et l’argument du socle de la section précédente tient — mais pas pour la raison qui l’avait fait écrire. Le socle s’ouvre bel et bien. Il s’ouvre parce que les acteurs en place l’ont ouvert eux-mêmes, dans l’ordre qui leur coûtait le moins :
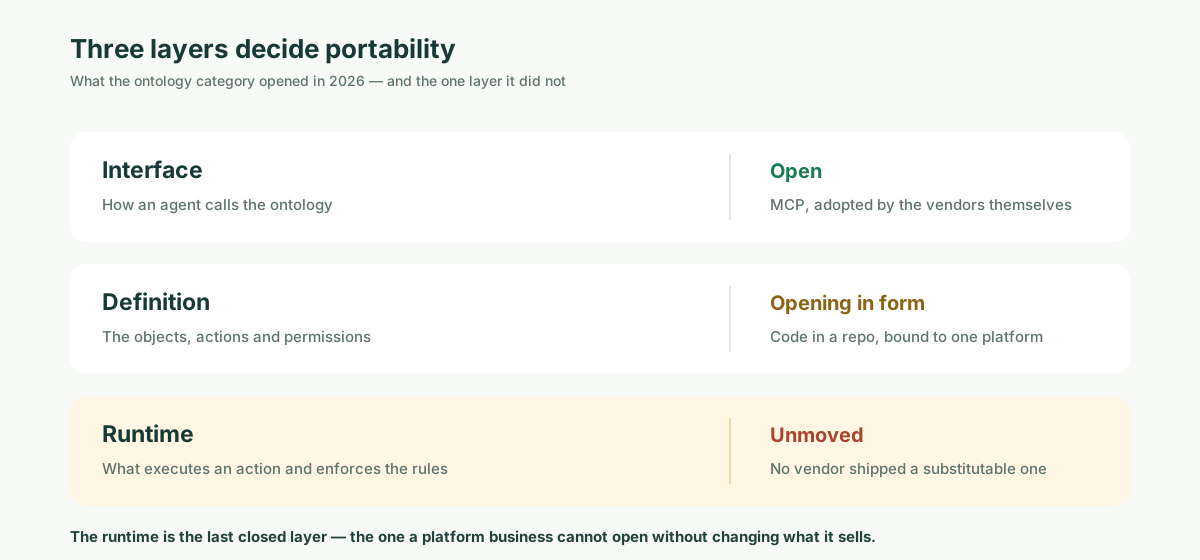
| Couche | Ce que c’est | Où 2026 l’a laissée |
|---|---|---|
| Interface | Comment un agent appelle l’ontologie | Ouverte. MCP, adopté par les éditeurs eux-mêmes |
| Définition | Les objets, les actions et les permissions | En cours d’ouverture, sur la forme. Déclarée comme du code dans un dépôt — elle atterrit toujours sur la plateforme d’un seul éditeur |
| Runtime | Ce qui exécute une action et applique les règles | Immobile. Aucun éditeur n’en a livré un que vous puissiez exécuter ailleurs |
Lisez la troisième ligne lentement, car l’argument entier s’y trouve.
Une interface ouverte rend une ontologie appelable. Des définitions dans un dépôt la rendent lisible et relisible. Ni l’une ni l’autre ne la rendent exécutable ailleurs. La portabilité de la définition n’est pas la portabilité du système : un monorepo rempli de code d’ontologie se matérialise quand même sur un enrollment Foundry. Et comme la surface d’outils est projetée depuis la définition, celui qui fait tourner la projection décide de ce que sont les outils. Un fichier de définition n’exécute rien par lui-même.
C’est le chiffre sur lequel repose cette mise à jour. Appliquez la règle de projection documentée par Palantir à une application de taille moyenne — 12 types d’objets, 30 types d’actions, 6 fonctions exposées — et vous obtenez 37 outils MCP parlant un protocole ouvert, et exactement un moteur en dessous capable de répondre à l’un quelconque d’entre eux. L’interface est devenue portable. La dépendance n’a pas bougé d’un pouce.
L’objection la plus forte, posée honnêtement : l’essentiel de ce qu’une équipe attend de la portabilité est désormais disponible. Vous pouvez lire votre modèle, le relire comme un diff, y pointer n’importe quel agent et — pour la sémantique analytique — l’échanger via une spécification neutre entrée à l’Apache Incubator en 2026. Si votre ontologie ne fait jamais que répondre à des questions, c’est déjà presque suffisant, et cet article serait malhonnête de prétendre le contraire.
La réponse est la même ligne qui sépare une couche sémantique d’une ontologie dès le départ : elle tient exactement jusqu’au moment où quelque chose doit se produire. Dès qu’une action exposée modifie un enregistrement, tout ce qui vous importe vraiment — la vérification des permissions, la transaction, l’approbation au-delà d’un seuil, la ligne d’audit — est une propriété du moteur, pas du fichier ni du protocole. Vous pouvez exporter la phrase. Vous ne pouvez pas exporter l’application de la règle.
Appelons cet écart la dernière couche fermée. Ce n’est pas une accusation, mais la description de l’endroit où la catégorie s’est arrêtée. Deux des trois couches se sont ouvertes en neuf mois, en grande partie d’elles-mêmes. La troisième n’a pas bougé du tout — parce que c’est la seule couche qu’un métier de plateforme ne peut pas ouvrir sans changer ce qu’il vend.
À quoi ressemble cette « définition » concrètement
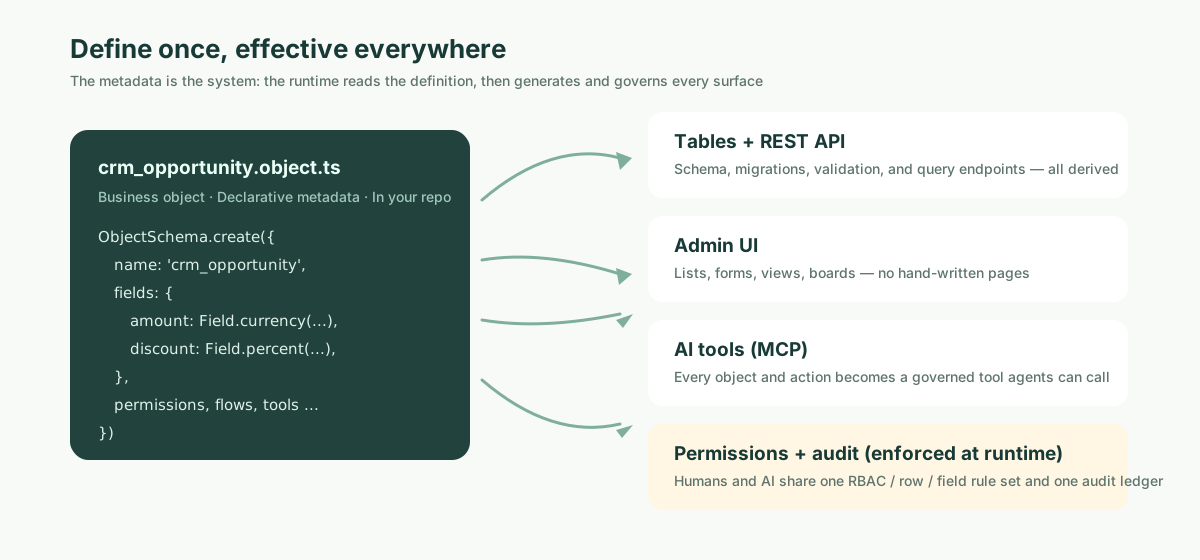
Assez d’abstraction. Voici un objet opportunité commerciale dans la définition typée d’application ObjectStack, abrégé d’un exemple réel :
export const Opportunity = ObjectSchema.create({
  name: 'crm_opportunity',
  label: 'Opportunité',
  fields: {
    name: Field.text({ label: 'Nom', required: true }),
    account: Field.lookup('crm_account', { label: 'Compte', required: true }),
    amount: Field.currency({ label: 'Montant', min: 0 }),
    probability: Field.percent({ label: 'Probabilité', defaultValue: 50 }),
    expected_revenue: Field.formula({
      label: 'Revenu attendu',
      expression: cel`amount * probability / 100`,
    }),
    discount_percent: Field.percent({ label: 'Remise %', max: 100 }),
  },
});

// Les permissions se déclarent de la même façon : les ventes lisent et écrivent, jamais de suppression
export const SalesUser: Security.PermissionSet = {
  name: 'crm_sales_user',
  objects: {
    crm_opportunity: { allowRead: true, allowCreate: true, allowEdit: true, allowDelete: false },
  },
};
L’important n’est pas la syntaxe. L’important, c’est que ces quelques dizaines de lignes sont le système. Le runtime open source ObjectStack lit la définition et en dérive les tables, l’API REST, l’interface d’administration et les outils MCP, tout en appliquant permissions et audit. Une remise supérieure à 30 % exige une validation finance ? C’est un flux attaché à l’objet : tout aussi déclaratif et versionné. ObjectOS ajoute autour de la même application l’expérience commerciale de production — Build et Ask dans le navigateur, revue et validation en équipe, exploitation cloud managée ou déploiement privé, SSO et support — sans rendre la définition ni le moteur propriétaires.
Trois conséquences en découlent directement :
- Les trois questions de sécurité du début reçoivent des réponses structurelles. Ce que l’IA peut voir — c’est écrit dans le jeu de permissions. Avec quels droits elle agit — elle agit en tant qu’utilisateur connecté, imposé par le runtime ObjectStack, pas supplié dans le prompt. Où est la piste d’audit — humains et agents écrivent dans le même registre : qui, quoi, quand, pourquoi. La conformité lit un seul journal, pas deux.
- Le changement métier devient une revue de code. L’IA veut ajouter un rappel de renouvellement ? Ce qu’elle soumet est un diff de métadonnées — quels champs changent, quelles permissions bougent, tout est visible d’un coup d’œil. Et comme les définitions sont versionnées, les erreurs se rétablissent.
- Le système entier tient dans la fenêtre de contexte d’un agent. Un module enterprise typique se condense de dizaines de milliers de lignes de CRUD et de glu en quelques centaines de lignes de déclarations — assez petit pour qu’une IA lise chaque dépendance de bout en bout, puis refactorise en toute sécurité à travers données, API, interface et permissions en un seul changement. C’est la frontière entre « l’IA co-mainteneuse » et « l’IA autocomplétion ».
La définition et le runtime portable appartiennent à la communauté ; l’exploitation est le business
Maintenant, l’argument se referme sur lui-même.
Le jugement de l’ontologie est juste — Palantir l’a prouvé pour toute l’industrie. À la première parution de cet article, « définition ouverte, moteur payant exclusif » était un mode de défaillance qu’il valait la peine d’annoncer. Neuf mois plus tard, ce n’est plus un avertissement : c’est une description honnête du point où la catégorie s’est fixée, atteint une décision raisonnable après l’autre par des éditeurs qui ont tout ouvert sauf ce qu’ils vendent. Cela rend l’alternative plus facile à énoncer, pas plus difficile : la définition métier typée et un runtime gouverné portable appartiennent à l’écosystème ouvert ; le produit payant est l’expérience de production opérée autour d’eux.
C’est exactement la division du travail entre ObjectStack et ObjectOS :
- ObjectStack est une ontologie métier ouverte (open business ontology) : la définition typée d’application, avec le runtime open source qui l’exécute (Apache 2.0). Objets, relations, permissions, flux, API, UI et outils IA sont définis une fois dans le dépôt ; le runtime dérive base de données, API REST, UI rendue et serveur MCP, puis applique permissions et audit à chaque appel. Définition et moteur sont versionnables, auto-hébergeables et portables — cette seconde moitié étant précisément celle que le reste de la catégorie a laissée fermée.
- ObjectOS est la plateforme commerciale de production autour de ces mêmes applications ObjectStack. Elle vend Build et Ask dans le navigateur, revue et validation en équipe, exploitation cloud managée ou déploiement privé, SSO, contrôles d’entreprise et support. Ce n’est pas un moteur d’exécution fermé qui vous reprend l’ontologie.
D’un côté : une définition d’application et un runtime portable que toute équipe ou tout agent peut comprendre, auto-héberger et emporter. De l’autre : l’expérience de production que les entreprises paient réellement — création collaborative, validations, hébergement, déploiement privé, SSO, support, mises à niveau et responsabilité opérationnelle. L’application et son runtime de base sont à vous. Les exploiter de façon fiable pour une équipe est le business.
Conclusion
Ce pilote IA mort au neuvième mois n’a jamais perdu contre la capacité du modèle. Il a perdu contre l’absence d’une couche sémantique qu’une équipe sécurité pouvait signer. Les grands fournisseurs ont montré la valeur de cette couche — et 2026 a passé neuf mois à démontrer quelque chose de plus étroit et de plus utile : les parties bon marché à ouvrir sont désormais ouvertes. L’interface est un protocole public. La définition est un fichier que vous pouvez lire. Reste le moteur qui transforme la seconde en la première et applique les règles au passage — et sur cette couche, rien ne s’est ouvert.
La question posée en juin prend donc une forme plus tranchante. Ce n’est plus « l’ontologie doit-elle être ouverte ? » — c’est réglé, et ce sont les éditeurs qui l’ont réglé. C’est : quand la dernière couche fermée est justement celle qui exécute vos règles métier, à qui voulez-vous que ce moteur appartienne ?
Si vous voulez vérifier que tout cela est réel :
npm i -g @objectstack/cli && os startDans cinq minutes, définissez votre premier objet métier et regardez le runtime ouvert ObjectStack le transformer en table, API, interface d’administration et outil qu’une IA peut appeler en toute sécurité. Chaque appel porte des permissions et s’inscrit au registre. Si votre équipe veut Build et Ask dans le navigateur, des revues et validations partagées, un cloud managé ou un déploiement privé, le SSO et le support, ObjectOS exploite cette même application ObjectStack ; elle ne la remplace pas par un format propriétaire ni un moteur exclusif.