Ontologie d'entreprise ouverte : qui doit posséder la couche sémantique du métier ?
Entre nov. 2025 et août 2026, cinq plateformes ont livré une couche sémantique métier et la plupart ont ouvert une voie de lecture MCP, en gardant la définition à l'intérieur. Protocole ouvert, définition fermée.
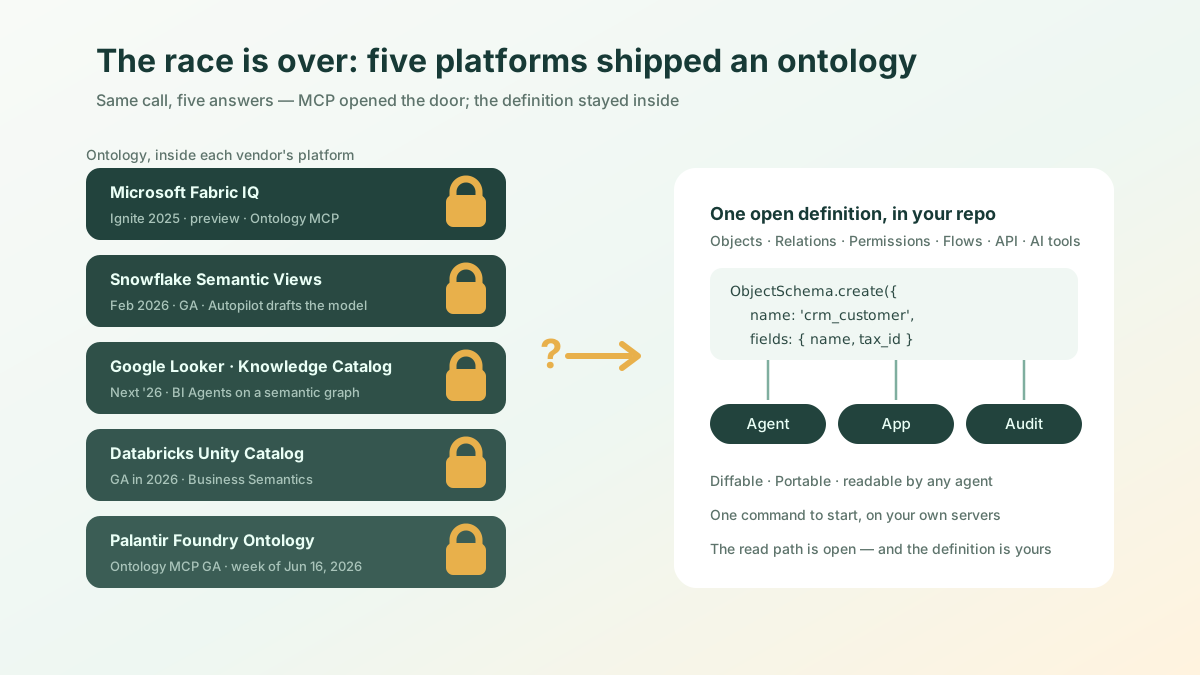
En bref : quand cet article a paru en juin 2026, il demandait qui posséderait la couche sémantique du métier. La course a depuis été courue : cinq plateformes en ont livré une en neuf mois. Et elles ont fait quelque chose que personne n’avait prévu : elles ont ouvert la voie d’accès à leur ontologie via MCP tout en gardant la définition à l’intérieur. Appelons cela protocole ouvert, définition fermée. Un agent peut désormais lire cinq ontologies qu’il ne peut pas emporter. Cela rend la question de la propriété plus aiguë, pas plus faible, et la réponse ne change pas : la couche de définition dont dépendent à la fois vos applications, vos agents, vos auditeurs et vos fournisseurs devrait être une couche neutre que vous détenez dans votre propre dépôt.
Commençons par la façon dont une entreprise a perdu un client exactement là-dessus. Les détails sont anonymisés, mais vous avez probablement déjà vu chaque étape.
Yuanfeng, le nom que nous donnerons à ce fabricant d’équipements industriels, réalise quelques milliards de chiffre d’affaires annuel et sert quelques milliers de clients. En 2024, il a misé son socle de données sur Microsoft et construit dans Fabric une ontologie propre : ce qu’est un « client », quels « équipements » se rattachent à un client, quels « ordres de travail » se rattachent à chaque équipement. Cette année-là, il est devenu le cas modèle répété dans les conférences fournisseurs.
En 2026, trois choses ont frappé Yuanfeng presque en même temps :
- L’équipe data science voulait faire tourner un lot de prédictions de renouvellement sur Gemini, parce que dans ce scénario précis c’était réellement plus précis ;
- La conformité a été informée que les données clients de l’UE devaient rester dans l’UE et ne pouvaient plus toucher le cloud américain ;
- Une acquisition s’est conclue, apportant toute une organisation commerciale — plusieurs milliers de clients — tournant sur Salesforce.
Yuanfeng s’est donc retrouvé avec trois « clients » : un dans Fabric, un dans Salesforce, et un de plus dans l’environnement européen isolé pour conformité.
Le tournant est venu sur un compte clé que nous appellerons Groupe H. Un jour, le directeur commercial a demandé à un agent : « Quel est le risque de non-renouvellement du Groupe H l’an prochain ? » L’agent a répondu : « Faible. » Il lisait l’ontologie Fabric, où les commandes récentes du Groupe H paraissaient saines et les chiffres étaient jolis.
Mais ce que l’agent ne voyait pas : dans les enregistrements Salesforce (apportés par l’acquisition), le Groupe H avait escaladé des réclamations au niveau de la direction deux fois en six mois ; dans l’environnement UE isolé, un litige de paiement en retard de 90 jours restait ouvert. Trois jeux de données appartenaient à trois « clients » qui s’ignoraient mutuellement, et aucune couche nulle part ne savait qu’il s’agissait du même Groupe H.
Un trimestre plus tard, le Groupe H est parti — des millions de perte annuelle. La conclusion du post-mortem était assez crue pour faire taire la salle : l’agent ne s’était pas techniquement trompé. La tranche de données qu’il voyait montrait réellement un risque faible. Ce qui était faux, ce n’était pas le modèle. C’était la définition de « client » sous ses pieds, découpée en trois.
Ce n’était pas simplement une erreur de Yuanfeng. C’est le résultat prévisible de confier « la définition de votre métier » à une plateforme, quand chaque plateforme ne protège et ne comprend que sa propre tranche.
La course que cet article nommait a maintenant été courue
Quand ce texte a paru pour la première fois, les concurrents étaient encore une prévision. Ils sont désormais un fait établi. Entre novembre 2025 et août 2026, cinq plateformes ont livré une couche sémantique métier :
| Plateforme | Ce qui a été livré | Quand |
|---|---|---|
| Microsoft Fabric IQ | Un élément Ontology plus une charge de travail d’agents complète — Graph, Data Agent, Operations Agent — en préversion publique, accessible à tout agent via des endpoints Ontology MCP publics | Ignite, nov. 2025 ; étendu avec règles et automatisation à FabCon Atlanta, mars 2026 |
| Snowflake | Semantic View Autopilot, GA — rédige les vues sémantiques à partir de votre historique de requêtes et de vos actifs BI au lieu de demander à un comité de définir « chiffre d’affaires » depuis zéro | 3 févr. 2026 |
| Looker BI Agents ancrés dans la couche sémantique de Looker, et Dataplex renommé Knowledge Catalog, qui transforme les métadonnées du catalogue en graphe sémantique avec une API de contexte pour agents | Cloud Next ‘26, avr. 2026 | |
| Databricks Unity Catalog | Business Semantics, GA — vues de métriques gouvernées et métadonnées d’agents définies une fois au niveau de la couche de données, l’implémentation centrale étant ouverte dans Apache Spark | GA en 2026 ; Business Glossary et Domains au Data + AI Summit, juin 2026 |
| Palantir Foundry | Ontology MCP est passé en GA sur toutes les installations Foundry — types d’objets, types d’actions et fonctions exposés à tout client MCP comme outils appelables | Semaine du 16 juin 2026 |
Deux choses à dire tout haut sur ce tableau avant de poursuivre l’argument.
Cet article n’est pas l’endroit pour les comparer case par case. Capacité par capacité, chaque cellule sourcée à la documentation du fournisseur lui-même, c’est un autre texte : Fabric IQ vs Palantir vs Unity Catalog vs Snowflake. Il tranche lesquelles modélisent des actions plutôt que de seulement décrire le métier, la ligne qui décide le plus. Lisez-le si vous choisissez. Lisez celui-ci si vous décidez de ce qu’il faut posséder.
Ce sont les dates qui font l’argument, pas les listes de fonctionnalités. Neuf mois, cinq plateformes, cinq décisions indépendantes selon lesquelles cette même couche valait d’être construite. Plus personne n’a besoin d’être convaincu que l’IA en entreprise exige une couche de définition métier lisible par machine et gouvernée. Cette moitié de la question est close.
Une clarification appartient toujours ici, car les trois mots en jeu sont couramment employés comme synonymes et ne le sont pas : ontology vs semantic layer vs knowledge graph fixe ce que chacun peut et ne peut pas répondre. La discussion sur la propriété ci-dessous suppose que vous avez déjà décidé de quelle couche vous parlez.
Le retournement : protocole ouvert, définition fermée
Voici la partie qui n’a pas tourné comme prévu, et c’est le changement le plus important depuis juin.
Les plateformes ne sont pas restées murées. Elles se sont ouvertes — via MCP. Fabric IQ expose des endpoints Ontology MCP publics. Palantir a rendu Ontology MCP généralement disponible sur toutes les installations Foundry la semaine même où cet article a paru pour la première fois. Snowflake fournit un serveur MCP managé. Google a placé une API de contexte devant Knowledge Catalog. Sur les quatre plateformes du comparatif lié, trois exposent leur couche sémantique aux agents via MCP.
À première vue, on dirait que la réponse ouverte est arrivée d’elle-même. Ce n’est pas le cas, et la distinction mérite d’être précise :
MCP normalise la façon dont un agent atteint votre ontologie. Il ne normalise rien quant à qui la détient.
Un endpoint MCP est une voie de lecture, pas un titre de propriété. Votre agent obtient un moyen propre, gouverné et neutre d’interroger une définition qui vit toujours sur la plateforme d’un autre, qui est toujours versionnée par son train de livraisons, et qui part toujours avec lui quand vous partez. Le protocole est ouvert. La définition est fermée. Protocole ouvert, définition fermée.
Cela compte parce que les deux se confondent précisément dans la direction qui coûte cher. « N’importe quel agent peut la lire » sonne comme de la portabilité. C’est l’inverse : c’est ce qui rend confortable le fait de ne pas être portable.
Pourquoi cela aggrave la fragmentation au lieu de l’atténuer
Avec la dépendance à un fournisseur unique, votre définition métier reste au moins une copie complète — vous ne pouvez simplement pas la déplacer. Douloureux, mais entier.
Cinq plateformes détenant chacune sa propre ontologie produisent autre chose : la fragmentation. Le « client » de Yuanfeng n’était pas seulement enfermé ; il était découpé en trois et rangé dans trois plateformes qui s’ignoraient. Deux mécanismes empêchent cela de se soigner tout seul, et MCP vient d’en ajouter un troisième.
La première couche, ce sont les incitations. Vous pourriez penser : il suffit que l’ontologie de Microsoft comprenne le « client » de Salesforce. Ce ne sera pas si simple, car l’ontologie de chaque fournisseur fait partie de ses douves. Si Microsoft unifiait unilatéralement sa sémantique du « client » avec celle d’un rival, il aiderait ce rival à déplacer ses données plus facilement et réduirait sa propre différenciation. L’unification est stratégiquement peu attrayante pour chaque concurrent de la course. Ce n’est pas un simple oubli technique ; c’est un comportement de plateforme rationnel.
La deuxième couche est technique. Même en écartant les incitations, l’alignement sémantique entre ontologies est difficile : le « client » du système A égale-t-il l’« Account » du système B ? Les définitions de champs, les cycles de vie, les règles de déduplication et les critères de « même entité » diffèrent d’un système à l’autre. L’IA ne peut pas non plus déduire cela de façon fiable. Les agents se trompent précisément parce que cette couche de définition déterminée manque. Retour au Groupe H : laissez l’agent deviner si « ces trois enregistrements sont la même entreprise », et le coût de l’erreur est exactement la perte de l’histoire.
La troisième couche est nouvelle, et c’est la plus gênante : MCP abaisse le coût de tolérer la fragmentation. Avant, câbler un agent sur cinq couches sémantiques déconnectées faisait assez mal pour que quelqu’un finisse par faire remonter le problème et que le projet de réconciliation obtienne un budget. Aujourd’hui, ce sont cinq enregistrements d’endpoints en une après-midi. L’agent tiendra volontiers cinq outils qui répondent différemment à « qui est ce client », et il répondra avec assurance depuis celui qu’il a atteint en premier. La douleur d’intégration qui forçait autrefois la réconciliation a été supprimée ; la fragmentation contre laquelle elle mettait en garde, non.
En une ligne : vous pensiez acheter cinq outils ; vous avez en réalité acheté cinq sources de vérité qui s’ignorent, désormais commodément adressables. Plus il y a de systèmes, d’acquisitions et d’isolement pour conformité, plus cette fragmentation devient sévère. L’ère des agents en amplifie le coût, car un humain peut encore réconcilier à la main entre plusieurs systèmes, si pénible soit-ce, alors qu’un agent en est incapable : il lui faut une couche de définition déterminée et cohérente entre systèmes avant de pouvoir raisonner.
Pour éviter la fragmentation, la définition de votre métier ne peut pas appartenir entièrement à une plateforme qui concourt dans la course. Il lui faut être une couche neutre : une définition que vous détenez vous-même et que les outils de différents fournisseurs peuvent lire. Les plateformes fermées peinent structurellement à fournir cela, car elles sont concurrentes de la course et ne peuvent pas être en même temps arbitres neutres.
D’abord, le scénario par lequel les plateformes fermées gagnent
Si tout ce que vous savez faire est répéter « l’ouvert c’est bien », c’est du prêche, pas de l’analyse. Les plateformes fermées tiennent quatre vraies cartes, et les neuf derniers mois en ont renforcé deux.
Premièrement, la qualité de modélisation. Transformer vingt ans de complexité d’entreprise accumulée en une ontologie propre et cohérente est une ingénierie lourde. Palantir l’aligne concept par concept avec des ingénieurs sur site, à un niveau que les communautés open source n’égalent pas vite. Avec une ontologie, mal la construire peut être pire que ne pas la construire. Ce modèle sur site a sa propre économie, et elle voyage moins bien que l’intitulé de poste — pourquoi copier le modèle forward-deployed construit un cabinet de conseil démonte ce qui doit exister en dessous pour que le travail se capitalise.
Deuxièmement, une seule partie responsable. Quand quelque chose casse, quelqu’un décroche, il y a un SLA, et il y a un contrat derrière. Pour un DSI, « un fournisseur porte la responsabilité de toute la couche » a une valeur réelle.
Troisièmement, beaucoup d’entreprises sont vraiment « pour l’essentiel sur une seule pile ». Si 80 % de votre activité vit déjà dans un écosystème, alors « le meilleur au sein de l’écosystème » peut littéralement être votre meilleure option. Les bénéfices de l’ouverture sont plus difficiles à exploiter si votre activité n’est pas transverse.
Quatrièmement — et cette carte s’est renforcée — le problème du démarrage à froid. L’Autopilot de Snowflake rédige le modèle sémantique à partir de l’historique de requêtes que vous avez déjà ; Fabric IQ laisse des experts métier écrire l’ontologie dans un outil visuel sans code plutôt que d’attendre les ingénieurs data. Les deux attaquent le vrai obstacle, qui n’a jamais été la technologie mais le comité de modélisation de six mois. Un format ouvert vous tend un fichier et une page blanche.
Les quatre cartes sont réelles. La conclusion n’est donc pas « les plateformes fermées sont toutes des pièges ». Pour les entreprises confortablement installées dans un écosystème, elles sont souvent la bonne réponse. Le problème apparaît chez les entreprises comme Yuanfeng : la prémisse expire.
Comment savoir que vous êtes en train d’être fragmenté
Ce n’est pas abstrait ; il y a des symptômes précoces concrets. Confrontez-vous à la liste ci-dessous. Si trois ou plus sont vrais, la fragmentation est déjà en cours chez vous.
- Le même « client / commande / équipement » est défini différemment selon les systèmes et ne se rapproche pas ; chaque rapport exige un recollage manuel.
- Vous posez à un agent une question transverse et il louvoie ou n’a raison qu’à moitié (il a vu un système, manqué l’autre).
- Chaque fois que vous branchez un nouveau système, vous devez réapprendre à l’IA « ce que c’est » et « ce que signifient les champs ».
- Une acquisition s’est conclue il y a plus d’un an et les données de référence des deux côtés n’ont toujours pas vraiment fusionné ; chaque côté remonte sa propre version.
- La conformité impose d’isoler une classe de données, si bien que la même entité existe en plusieurs copies qui ne se reconnaissent pas.
- On a donné à votre agent plus d’un outil de couche sémantique, et personne n’a écrit lequel l’emporte quand ils se contredisent.
Avant que Yuanfeng ne perde le Groupe H, quatre des cinq premiers étaient vrais. À l’époque, ils étaient classés en « chantiers de gouvernance des données », et personne n’y voyait des risques qu’un agent finirait par exposer. Le sixième est l’ajout de 2026, et c’est celui qui arrive sans bruit, parce qu’ajouter le deuxième endpoint ressemble à un progrès.
Un peu d’eau froide : l’ouvert n’est pas une baguette magique, et le domaine se normalise
Arrêtons-nous ici honnêtement, sinon cela devient un argumentaire commercial. Il y a trois contrepoids légitimes, et le troisième est nouveau.
Premièrement, échanger la définition contre un protocole ouvert ne fusionne pas automatiquement les trois « clients » de Yuanfeng en un seul. La modélisation sémantique, la déduplication et l’alignement des définitions restent à faire. Il n’y a pas de baguette magique ici, et ne croyez personne qui en promet une. Ce que l’ouvert change vraiment, c’est la propriété de ce travail difficile : la définition que vous alignez aujourd’hui est écrite dans votre propre dépôt, pas enfouie dans le back-office d’une plateforme. L’an prochain, quand vous changerez de modèle, de cloud, ou serez racheté, ce que vous refaites c’est la connexion, pas la définition elle-même.
Deuxièmement, « ouvert » en soi ne garantit pas de gagner. Historiquement, pour qu’un standard ouvert s’impose, il faut en général aussi une bonne implémentation de référence et un écosystème actif. Publier un protocole que personne ne rend agréable à utiliser ne suffira pas. Choisir l’ouvert, c’est donc parier que quelqu’un le construira bien. C’est un risque d’exécution, pas une victoire garantie.
Troisièmement — et c’est l’argument le plus fort contre la position de cet article — les fournisseurs normalisent eux-mêmes la couche de définition. Snowflake a cofondé l’Open Semantic Interchange avec Salesforce, dbt Labs, BlackRock et RelationalAI ; l’initiative est entrée à l’Apache Incubator en juillet 2026 sous le nom d’Apache Ossie, avec plus de 50 organisations membres dont Databricks, Oracle et Collibra. Databricks ouvre séparément le code de son implémentation de vues de métriques dans Apache Spark. C’est réel, et plus rapide que ce que réussissent la plupart des efforts de couche neutre ; soutenir aujourd’hui que les plateformes fermées ne convergeront jamais, c’est argumenter contre les faits.
Mais regardez bien où cette convergence s’arrête. Ossie couvre la sémantique analytique — métriques, dimensions, relations. Les actions et les permissions sont hors périmètre. Autrement dit, la moitié de votre ontologie qui décrit le métier devient portable, tandis que la moitié qui le change — les opérations, qui a le droit de les exécuter, et ce qui est écrit au journal d’audit — reste propriétaire. Ce n’est pas un petit reliquat. C’est la moitié qui décide si un agent peut faire quoi que ce soit, et exactement la moitié où la fragmentation coûte le plus cher.
Aucun de ces trois points ne dit que le fermé est meilleur. Ils disent que l’ouvert demande aussi des efforts, porte aussi des risques, et qu’on vient partiellement à sa rencontre. Mettez cela en balance avec l’inconvénient d’enfermer la définition de votre métier dans une plateforme, puis de la fragmenter entre cinq. Aucun camp n’est gratuit ; l’un des deux garde l’actif central entre vos mains.
Les couches dont tout le monde dépend finissent neutres
Le schéma lui-même n’est pas nouveau, mais il mérite d’être raconté avec des exemples frais, car il se reproduit sans cesse.
La « couche de définition » dont tout un écosystème dépend collectivement tend à devenir neutre. L’exemple le plus ancien est SQL : les éditeurs de bases de données se sont livré une concurrence féroce, et pourtant le langage de requête lui-même est resté public. Deux exemples plus récents : OpenTelemetry, le standard de données d’observabilité hébergé par la CNCF neutre, et LSP (le Language Server Protocol), ouvert par Microsoft et adopté par de nombreux éditeurs justement parce qu’il était ouvert.
L’exemple de LSP est particulièrement utile parce que Microsoft a lui-même prouvé le schéma : ouvrir la couche de définition et se battre sur la meilleure implémentation peut créer plus de valeur que de verrouiller la couche. Notez toutefois ce que LSP a réellement ouvert — le protocole et la définition de ce qu’un serveur de langage doit fournir. Pour les ontologies, MCP a fait la première moitié. Apache Ossie tente la seconde moitié pour la partie analytique. Pour la partie qui agit, personne ne l’a encore fait.
Une couche dont dépendent simultanément vos applications, vos agents, vos systèmes d’audit et les outils de cinq fournisseurs ne peut pas rester privée chez l’un d’eux sans continuer à produire le genre de fragmentation qu’a subi Yuanfeng.
À quoi ressemble la couche neutre
Après tout cela, regardons la chose réelle. Le point n’est pas la syntaxe ; c’est où vit la définition, si vous pouvez l’emporter, et si elle peut rattraper la fragmentation.
Supposons que Yuanfeng ait dès le départ construit « client » comme une définition neutre : brancher les trois systèmes comme sources de données, modéliser chacun en objets, puis les aligner en un seul « client » gouverné par une clé partagée (le numéro fiscal) — une déclaration dans votre propre dépôt qui est la source unique de vérité :
export const Customer = ObjectSchema.create({
  name: 'crm_customer',
  label: 'Customer',
  fields: {
    name: Field.text({ label: 'Customer name', required: true }),
    tax_id: Field.text({ label: 'Tax ID' }), // clé partagée pour aligner « le même client » entre systèmes
  },
});
Cette définition vit dans votre dépôt Git : diffable, relisable, migrable. Ce qu’elle peut faire ensuite est le nœud — transformer « portable » en une action démontrable, pas en une promesse :
git add crm/*.ts          # La définition est dans votre gestion de versions : auditable, réversible
os start   # La même définition, tournant sur votre propre infrastructure
# Puis pointez n'importe quel modèle dessus — Claude, GPT, Gemini — le runtime ne change pas
Reposez maintenant la question critique : « Quel est le risque de non-renouvellement du Groupe H l’an prochain ? » L’agent voit désormais un « client » unifié, avec permissions et audit : des commandes saines, superposées à deux réclamations remontées à la direction et à un litige de paiement de 90 jours. Il répond : « Risque élevé ; intervention précoce recommandée. » Même modèle, même question. Parce que la définition en dessous n’est plus fragmentée, la conclusion passe de « des millions perdus » à « alerté un trimestre entier à l’avance ».
Le point sur MCP s’applique ici aussi, et dans la direction qui compte : cette même définition est ce que le runtime sert aux agents sous forme d’outils gouvernés, de sorte que la voie de lecture est ouverte et que la définition est la vôtre. C’est l’argument que pourquoi la définition et le runtime devraient tous deux être ouverts développe en entier.
C’est la division du travail entre ObjectStack et ObjectOS, et sa réponse à cette course :
- ObjectStack — une open business ontology (ontologie métier ouverte) : le protocole de définition ouvert et le runtime auto-hébergé open source (Apache 2.0). La définition vit dans votre dépôt, l’agent de n’importe quel fournisseur peut la lire, et le runtime la valide et l’exécute avec permissions et audit ;
- ObjectOS — la plateforme de production commerciale optionnelle et l’expérience opérée pour cette même application ObjectStack — cloud ou auto-gérée — qui ajoute la construction par IA dans le navigateur, le déploiement et l’exploitation, sans remplacer la définition ni le runtime ouverts en dessous.
La définition et le runtime auto-hébergé restent ouverts et neutres ; l’expérience de production commerciale est là où les produits se concurrencent. C’est la même relation que SQL entretient avec les éditeurs de bases de données, et LSP avec les éditeurs de code.
Et pour être honnête sur l’échange : sur la profondeur de modélisation, le démarrage à froid et la sémantique analytique à l’échelle d’un entrepôt, les plateformes ci-dessus sont en avance, et l’article comparatif dit en détail où. Ce qui diffère ici est plus étroit que « meilleur » — la définition est un fichier ordinaire dans votre dépôt sous licence ouverte, et le runtime qui l’applique, c’est vous qui l’hébergez.
Conclusion
Ce n’est pas une question idéologique d’« ouvert c’est bien » ou « fermé c’est bien ». C’est une question d’architecture plus froide : quand votre combinaison de fournisseurs changera — adoption multi-modèles, stratégie multi-cloud, acquisition, isolement de conformité — qui détiendra la définition de votre métier ?
Il y a neuf mois, cette question était hypothétique, parce que le domaine n’avait encore rien livré. C’est fait. Cinq plateformes ont prouvé que la couche valait d’être construite, puis la plupart ont ouvert une porte d’entrée sur une maison qui ne vous appartient pas. Un endpoint MCP sur l’ontologie d’un autre est une chose réellement utile — ce n’est simplement pas la même chose que posséder la définition, et c’est dans l’écart entre les deux qu’est passé le Groupe H de Yuanfeng.
Une couche dont tout le monde dépend reste rarement longtemps chez une seule entreprise. Il n’y a aucune raison que celle-ci fasse exception.
npm i -g @objectstack/cli && os startDéfinissez votre premier objet métier, faites venir ses données de deux systèmes existants, puis faites-en un git commit dans votre propre dépôt. À cet instant, la définition de votre métier est de retour entre vos mains, pas dans le back-office de quelqu’un d’autre.