Comment importer un tableur d’un ancien système dans une application construite par l’AI ? Mappings d’import, essais à blanc et les trois façons dont une ligne peut ne pas correspondre
Mesuré sur ObjectStack 18.3.0 : un mapping d’import projette en-têtes et codes étrangers sur un objet, un essai à blanc renvoie le rapport par ligne sans rien écrire, une ligne sans correspondance est créée, ignorée ou rejetée.
En bref. Le tableur venu de l’ancien système a des en-têtes qui ne sont pas vos noms de champs et des codes qui ne sont pas vos codes. La solution est un mapping d’import : une projection nommée et versionnée des colonnes du fichier vers les champs d’un objet, dans laquelle map traduit les codes de l’autre système et upsertKey décide ce que « la même ligne » veut dire. Le mapping est strict : une colonne qu’il ne nomme pas n’atteint jamais le chemin d’écriture. dryRun: true renvoie le rapport complet ligne par ligne sans rien enregistrer. Mesuré sur la @objectstack/cli 18.3.0 publiée : un CSV de 3 lignes est revenu de l’essai à blanc avec created: 3 alors que la table comptait encore 0 ligne, comptait 3 lignes après l’exécution réelle, et a répondu updated: 3 quand le même fichier a été renvoyé. L’essai à blanc, c’est la revue : un décompte avant-après que vous validez avant que quoi que ce soit n’atterrisse.
Tout ce qui suit a été exécuté, pas décrit. L’application est un échafaudage neuf de npm create objectstack@latest sur 18.3.0 portant l’objet Lead de l’exemple CRM livré dans le dépôt ObjectStack, et chaque chiffre est cité du rapport du serveur lui-même.
Le fichier qui arrive chaque lundi
Voici le fichier. Il fait trois lignes pour tenir entier sur la page ; la mécanique est la même à trois mille.
Full Name,E-mail,Company,Channel,Legacy ID
Ada Lovelace,ada@example.com,Analytical Engines,Webform,L-1001
Alan Turing,alan@example.com,NPL,Partner Referral,L-1002
Grace Hopper,grace@example.com,Eckert-Mauchly,Webform,L-1003
Et voici l’objet dans lequel il doit atterrir. Le crm_lead de l’exemple CRM déclare un name, un email, un company et un champ de sélection source dont les valeurs stockées sont web, referral, event, social, cold_outreach et partner.
Trois choses clochent dans ce fichier, et ce sont les trois choses que tout export d’un autre système fait de travers :
- Les en-têtes sont les leurs.
Full Nameest notrename;E-mailest notreemail. - Les codes sont les leurs. Leur
Webformest notreweb; leurPartner Referralest notrepartner. Aucune des deux graphies n’existe de notre côté. - Une colonne ne doit pas atterrir.
Legacy IDest la clé primaire de l’ancien système. Elle n’a pas de champ ici, et ne doit pas en acquérir un par accident.
Un renommage ponctuel dans un assistant d’import règle le premier problème et rien d’autre. Les deux autres demandent quelque chose d’écrit une fois et appliqué chaque semaine.
Un mapping d’import est une projection, pas un renommage
La documentation ObjectStack définit l’artefact en une phrase : « Un mapping d’import est une projection nommée et réutilisable des colonnes d’un fichier source vers les champs d’un objet. » C’est un type de métadonnées de premier rang : il est livré dans un paquet ou enregistré à l’exécution, et POST /api/v1/data/:object/import l’applique par son nom. Voici celui que les mesures ci-dessous ont utilisé, déclaré dans le code de l’application à côté des objets :
import { defineMapping } from '@objectstack/spec/data';

export const LeadFeedMapping = defineMapping({
  name: 'crm_lead_feed',
  label: 'Lead feed (legacy CRM export)',
  sourceFormat: 'csv',
  targetObject: 'crm_lead',
  fieldMapping: [
    { source: 'Full Name', target: 'name' },
    { source: 'E-mail', target: 'email' },
    { source: 'Company', target: 'company' },
    {
      source: 'Channel',
      target: 'source',
      transform: 'map',
      params: { valueMap: { Webform: 'web', 'Partner Referral': 'partner' } },
    },
  ],
  mode: 'upsert',
  upsertKey: ['email'],
});
Il est enregistré sur le stack avec mappings: [LeadFeedMapping], et defineStack() le valide au build plutôt qu’au premier usage : un targetObject que le stack ne définit pas fait échouer le build, et une transformation javascript aussi (voir plus bas). Comme defineMapping() analyse la configuration au moment de l’import, une clé mal orthographiée est rejetée là où vous l’avez écrite, avec la graphie canonique nommée dans l’erreur. C’est ce qui fait du mapping des métadonnées typées plutôt qu’un fichier de configuration : un relecteur lit vingt lignes et sait que la projection est bien formée avant qu’une seule ligne ne soit lue.
| Clé | Ce qu’elle décide |
|---|---|
fieldMapping[] | Une entrée par champ cible : quelle colonne source l’alimente, et par quelle transformation |
transform: 'map' + valueMap | Traduit les codes du système source dans les vôtres. Une valeur sans entrée dans la table passe inchangée |
mode | Fournit le writeMode de la requête quand elle l’omet : insert, update ou upsert |
upsertKey | Fournit les matchFields de la requête : les champs qui décident si une ligne est « la même ligne » qu’un enregistrement stocké |
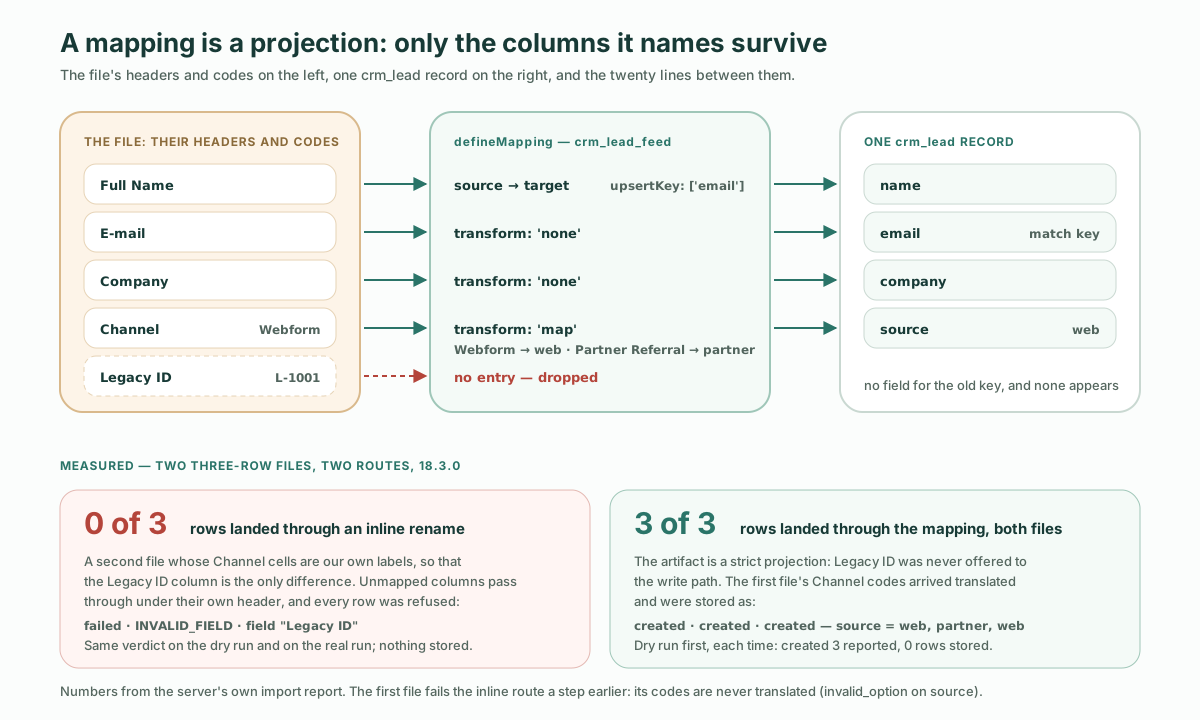
Le mot qui compte dans la définition est projection. Le point d’entrée d’import accepte deux mécanismes de mapping, et ils diffèrent exactement sur le troisième problème ci-dessus. Un mapping inline dans la requête est un renommage : sa forme tableau peut rogner une cellule, changer sa casse ou remplir une cellule vide, mais elle n’a pas de table de codes, et les colonnes qu’il ne nomme pas « passent au chemin d’écriture sous leur propre en-tête ». Un mapping nommé est l’inverse : les colonnes non mappées sont « écartées. L’artefact est une projection stricte : seules les cibles mappées survivent. »
Cette différence est mesurable, donc elle a été mesurée, sur un second fichier de trois lignes construit pour que la colonne superflue soit la seule chose sur laquelle les deux voies puissent diverger : ses cellules Channel portent nos propres libellés d’options (Website, Partner), qui se résolvent sans aucun mapping, et il porte la colonne Legacy ID. Il a été envoyé avec un renommage inline des quatre colonnes connues, en essai à blanc et en exécution réelle, et avec mappingName: "crm_lead_feed" en essai à blanc :
| Voie | Lignes atterries | Ce que le rapport a dit de chaque ligne |
|---|---|---|
mapping inline, essai à blanc | 0 sur 3 | failed, code: "INVALID_FIELD", field: "Legacy ID", “Unknown field ‘Legacy ID’ on object ‘crm_lead’” |
mapping inline, exécution réelle | 0 sur 3 | Les trois mêmes verdicts ; rien d’enregistré |
mappingName, essai à blanc | 3 sur 3 | created |
La voie inline n’est pas cassée. Elle a fait ce que fait un renommage : elle a laissé passer Legacy ID sous son propre en-tête, et le chemin d’écriture a rejeté un champ que l’objet ne déclare pas. Le mapping n’a jamais laissé la colonne approcher du chemin d’écriture. Le premier fichier, avec ses codes Webform et Partner Referral, échoue sur la voie inline une étape plus tôt : chaque ligne est refusée avec invalid_option sur source, “Lead Source: ”Webform“ is not a known option”, parce que rien n’a traduit les codes. Pour un fichier qui arrive chaque semaine d’un système que vous ne contrôlez pas, ces deux garanties sont la raison d’écrire les vingt lignes.
Le mapping peut aussi être enregistré à l’exécution au lieu d’être livré dans le paquet : PUT /api/v1/meta/mapping/crm_lead_feed_saved avec la même forme sous un nouveau nom a répondu Saved mapping 'crm_lead_feed_saved' (env-wide, state=active) [seq=1], et un essai à blanc qui le nommait a rapporté created 3. Dans les deux cas, la requête d’import résout un mapping par son nom ; le runtime lit d’abord les mappings enregistrés puis se rabat sur celui du paquet. Le nom du paquet lui-même est verrouillé : le même PUT vers crm_lead_feed a été refusé avec 403 NOT_OVERRIDABLE.
L’essai à blanc, c’est la revue
La requête qui rend le mapping utile est courte, parce que l’artefact fournit le mode d’écriture et les champs de correspondance :
POST /api/v1/data/crm_lead/import
{
  "format": "csv",
  "csv": "Full Name,E-mail,Company,Channel,Legacy ID\nAda Lovelace,...",
  "mappingName": "crm_lead_feed",
  "dryRun": true
}
L’essai à blanc est revenu avec le rapport entier, compteurs agrégés plus un verdict par ligne :
{ "object": "crm_lead", "dryRun": true, "writeMode": "upsert",
  "total": 3, "ok": 3, "errors": 0, "created": 3, "updated": 0, "skipped": 0,
  "results": [
    { "row": 1, "ok": true, "action": "created" },
    { "row": 2, "ok": true, "action": "created" },
    { "row": 3, "ok": true, "action": "created" } ] }
Puis la table a été lue : "total": 0. Rien n’avait été enregistré. Le même corps sans dryRun a répondu "created": 3 avec un id sur chaque ligne, et la table lisait "total": 3, avec source contenant web, partner et web, les codes traduits plutôt que ceux du fichier. Le même fichier envoyé une troisième fois a répondu "created": 0, "updated": 3, et la table lisait toujours 3. C’est tout l’avant-après, en trois chiffres :
| Étape | Rapport | Lignes dans la table ensuite |
|---|---|---|
| Essai à blanc | total 3 · created 3 · updated 0 | 0 |
| Exécution réelle | created 3 | 3 |
| Le même fichier à nouveau | created 0 · updated 3 | 3 |
Pourquoi appeler cela la revue plutôt qu’un aperçu ? Parce que c’est l’artefact qu’un relecteur peut réellement valider. La documentation le dit précisément : "dryRun": true renvoie « le même rapport sans rien persister ; le verdict vient de la validation du chemin d’écriture du moteur lui-même ». Ce n’est pas une supposition sur ce que ferait l’écriture ; pour chaque ligne, il demande son verdict au chemin d’écriture et s’arrête avant de persister. Ce qu’un responsable métier approuve avant que l’import du lundi ne tourne, ce sont donc deux petits objets : le mapping (vingt lignes de métadonnées typées, sous contrôle de version, lisibles comme un diff) et le rapport d’essai à blanc (combien de lignes seront créées, combien mises à jour, lesquelles échoueront et sur quelle colonne). Rien ne s’est encore produit quand ils signent, et la seconde exécution est la preuve que la première pensait ce qu’elle disait.
L’aperçu vaut aussi pour les lignes qu’il mettra à jour. Renvoyé une fois de plus alors que les trois lignes existaient, l’essai à blanc a répondu created 0 · updated 3, le même verdict que l’exécution réelle a ensuite rendu. Une mise à jour est prévisualisée contre l’enregistrement stocké fusionné avec les cellules du fichier, si bien qu’une règle qui lit un champ absent du fichier, comme le contrôle lead_score_range de l’objet Lead sur lead_score, juge l’enregistrement que l’écriture stockerait réellement. Avant 18.0, l’aperçu ne jugeait que les cellules entrantes et pouvait refuser une ligne que l’écriture acceptait ensuite. Une ligne que l’écriture admettrait malgré un constat seulement consultatif revient ok avec une liste warnings jointe, si bien que la remarque est visible dans le rapport au lieu d’être tue ; aucune des exécutions ici n’en a produit.
Les trois façons dont une ligne peut ne pas correspondre
upsertKey: ['email'] dit ce que « la même ligne » veut dire. Les cas intéressants sont les lignes pour lesquelles cette recherche ne trouve pas exactement un enregistrement. La documentation est directe : « une ligne qui ne correspond pas » n’est pas un comportement mais trois, choisis par writeMode et par le nombre d’enregistrements trouvés.
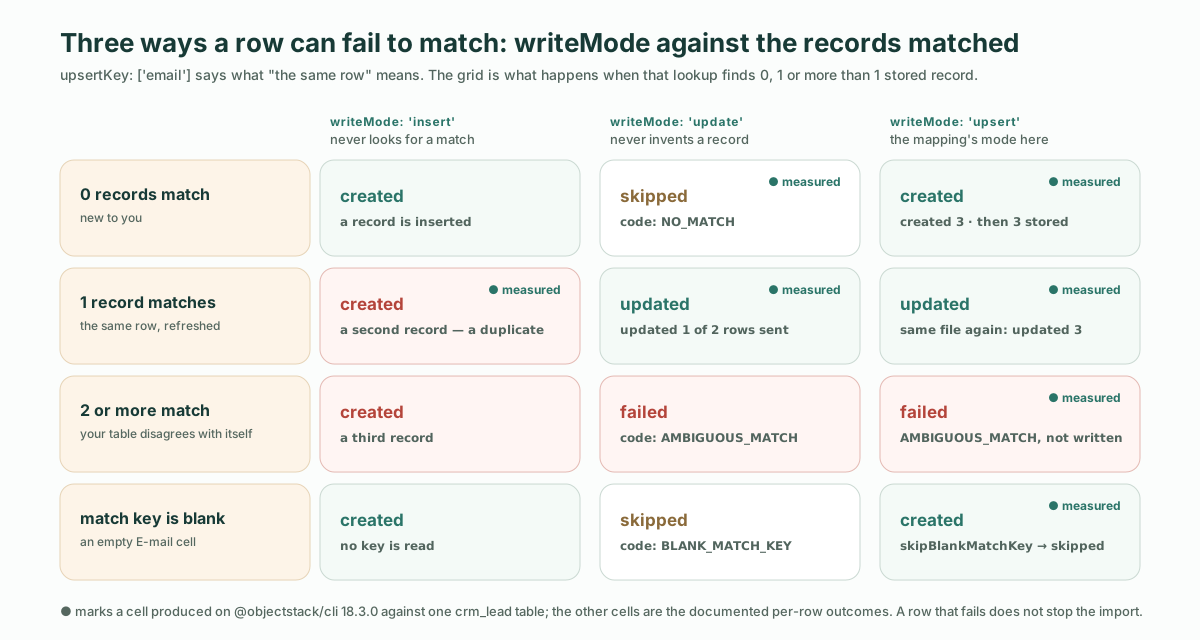
Les trois ont été produites contre la même table, et chacune est une réponse d’une nature différente :
| Lignes trouvées | writeMode: 'upsert' | writeMode: 'update' | Ce que cela signifie pour le fichier |
|---|---|---|---|
| 0 | created | skipped, code: "NO_MATCH" | Nouvelle pour vous. Upsert l’admet ; update refuse d’inventer un enregistrement |
| 1 | updated | updated | La même ligne, rafraîchie |
| 2 ou plus | failed, code: "AMBIGUOUS_MATCH" | failed, code: "AMBIGUOUS_MATCH" | Votre table se contredit déjà elle-même ; rien n’est écrit pour cette ligne |
Les exécutions mesurées : un fichier de deux lignes envoyé avec writeMode: "update" a répondu updated 1, skipped 1, la ligne de l’inconnu se lisant "action": "skipped", "code": "NO_MATCH". Puis une ligne a été chargée deux fois avec writeMode: "insert", qui ne cherche jamais de correspondance, si bien que la table contenait deux enregistrements avec le même e-mail, et la même ligne envoyée en upsert a répondu "action": "failed", "code": "AMBIGUOUS_MATCH", avec le message “matchFields matched more than one crm_lead record”. Le doublon est un fait sur la table, et l’import le signale au lieu d’en choisir un.
Il y a une quatrième ligne qu’il vaut la peine de connaître : celle dont le champ de correspondance est vide. Une ligne avec une cellule E-mail vide a été créée par l’upsert, parce qu’upsert crée ces lignes par défaut ; avec "skipBlankMatchKey": true sur la requête, la même ligne est revenue en "action": "skipped", "code": "BLANK_MATCH_KEY". Lequel des deux vous voulez dépend de savoir si un lead sans e-mail est un lead ou une coquille, et c’est une décision que porte la requête, pas le mapping.
La 18.2 a ajouté un cas de plus : un fichier qui se contredit lui-même. Quand deux lignes d’un même upsert ou update portent la même clé de correspondance, aucune n’est écrite, à l’essai à blanc comme à l’exécution réelle. Un fichier de trois lignes contenant deux fois frances@example.com a répondu ok 1 · errors 2 ; la troisième ligne a été créée, et les deux doublons sont revenus en "action": "failed", "code": "DUPLICATE_MATCH_KEY" avec ce message :
Rows 1, 2 of this import have the same match key (email), so none of them was written: keep one row per key and import againLa correction se fait dans le tableur : garder la ligne juste et renvoyer le fichier.
Après le mapping, la cellule doit encore être valide
Le mapping décide quelle valeur atterrit dans quel champ. Transformer cette valeur en quelque chose que le stockage accepte est une étape distincte, exécutée ensuite à partir des métadonnées de champ de l’objet cible, et les deux étapes échouent différemment. Un fichier de quatre lignes les a exercées en une seule requête :
| La cellule | Ce qui s’est passé | Le verdict de la ligne |
|---|---|---|
Channel = Trade Show, un code que la valueMap ne connaît pas | Le map l’a laissé passer inchangé, comme documenté ; la coercition du champ de sélection n’a ensuite trouvé aucune option nommée Trade Show | failed, field: "source", code: "invalid_option", “Lead Source: ”Trade Show“ is not a known option” |
Channel = Event, absent de la valueMap mais libellé d’une option existante | Passé inchangé ; résolu vers la valeur stockée event par son libellé, sans aucune entrée de mapping | created |
E-mail = not-an-email | La coercition propre au champ e-mail l’a refusée | failed, field: "email", code: "invalid_email" |
E-mail vide | Admise par l’upsert, comme ci-dessus | created |
Deux des quatre lignes ont atterri, deux non, et le rapport lisait "ok": 2, "errors": 2. Une ligne qui échoue n’arrête pas l’import ; elle reçoit sa propre ligne avec la colonne fautive nommée, et c’est la ligne que quelqu’un corrige dans le tableur avant le lundi suivant.
Le second cas mérite une phrase, parce qu’il délimite à quoi sert map. Les libellés de sélection se résolvent déjà en valeurs stockées sans aucun mapping, dans la langue de l’application et dans ses traductions. La valueMap n’est donc pas là pour apprendre à l’import vos libellés d’options ; elle est là pour les codes de l’autre système, les graphies qui ne sont ni vos valeurs ni vos libellés. Webform a besoin du map. Event n’en a jamais eu besoin.
Rejeté avant qu’une seule ligne ne soit lue
Certaines requêtes sont rejetées en bloc, sans rapport par ligne, parce qu’y répondre ligne par ligne masquerait une erreur dans la requête elle-même. Trois d’entre elles ont été mesurées ; le reste vient de la table documentée.
| Statut | code | Cause |
|---|---|---|
| 404 | MAPPING_NOT_FOUND | Aucun mapping enregistré sous ce nom. Mesuré : “No mapping artifact named ”crm_lead_feed_nope“ is registered” |
| 400 | CONFLICTING_MAPPING | À la fois mappingName et un mapping inline dans une requête. Mesuré : “Provide either mappingName or an inline mapping, not both” |
| 400 | MAPPING_TARGET_MISMATCH | Le targetObject de l’artefact n’est pas l’objet de l’URL |
| 400 | UNSUPPORTED_TRANSFORM | Une entrée déclare javascript, ou une transformation que le pipeline n’implémente pas |
| 413 | PAYLOAD_TOO_LARGE | Plus de 5 000 lignes sur la voie synchrone |
Le plafond est exact. Un fichier de 5 001 lignes a été refusé avec “Import limit is 5000 rows per request (got 5001). Use an async import job for larger files.” Un fichier de 5 000 lignes, en essai à blanc, est revenu avec "total": 5000, "ok": 5000, "created": 5000 en une seule réponse. Au-delà, POST /api/v1/data/:object/import/jobs analyse le même corps et accepte jusqu’à 50 000 lignes, en renvoyant un identifiant de tâche à interroger ; cette voie n’a pas été exercée ici.
Ce que cela ne résout pas
Du code sur mesure dans le mapping. TransformType déclare sept valeurs : none, constant, map, split, join, lookup et javascript. Les cinq premières s’exécutent ligne par ligne, lookup est un passage délibéré vers la résolution de références propre à l’import, et javascript est refusé, parce qu’« il n’y a pas de bac à sable côté serveur, et sauter en silence une transformation déclarée corromprait les données ». Les deux moitiés de ce refus ont été mesurées sur 18.3.0. Changer une entrée du mapping empaqueté en transform: 'javascript' a fait échouer objectstack build avec “Mapping ‘crm_lead_feed’ uses transform ‘javascript’, which the import path does not execute (no server-side sandbox). Use none/constant/map/split/join/lookup, or model the logic as a flow.” Enregistrer la même chose à l’exécution via PUT /api/v1/meta/mapping/... a été accepté, et le premier import qui l’a nommée a été refusé avec 400 UNSUPPORTED_TRANSFORM. Pour une logique au-delà des cinq transformations, la réponse de la documentation est de transformer les données avant de les envoyer, ou de la modéliser comme un flow sur l’objet cible. C’est aussi la bonne limite pour un relecteur : un mapping que l’on peut lire en entier est un mapping que l’on peut approuver.
Décider ce que l’ancienne colonne voulait dire. Le mapping consigne la décision selon laquelle Partner Referral signifie partner. Il ne la prend pas. Quelqu’un qui connaît les deux systèmes doit encore dire laquelle des six valeurs de source est un lead Trade Show, et si un lead sans e-mail est un lead.
L’assistant d’import, les automatisations et la voie asynchrone. L’assistant qui enregistre un mapping à partir des choix de colonnes d’un utilisateur est une surface produit que cet article ne couvre pas ; tout ici est resté sur la voie REST qu’un agent ou un script utiliserait. La requête accepte une clé runAutomations ; ce que les lignes déclenchent en entrant est un sujet à part entière. Et la voie des tâches à 50 000 lignes a été nommée, pas exécutée.
Où cela se situe dans une migration
C’est l’étape de chargement, et elle est délibérément petite. Si la question est de savoir s’il faut déplacer l’ancien système tout court, le chemin par étapes pour quitter un système interne hérité est la stratégie : se connecter en lecture seule, mesurer ses règles déclarées contre l’historique, activer les écritures objet par objet. Si l’ancien système reste et que vous voulez de l’AI sur ses données sans rien déplacer, connecter la base de données que vous exploitez déjà est le mécanisme, et la version industrielle montre par où commencer quand le système est un ERP. Les mappings d’import sont pour le cas intermédiaire : le système s’en va, ou il n’a jamais eu d’API, et ce que vous avez, c’est un fichier.
Hébergé, ou sur votre propre infrastructure
Tout ce qui précède a tourné sur le runtime open source qu’un échafaudage installe. ObjectOS existe en trois éditions : ObjectOS Community, open source et gratuite à auto-héberger ; ObjectOS Cloud, hébergée dans le navigateur, sans rien installer ; et ObjectOS Enterprise, autogérée sur votre propre infrastructure. Votre ontologie est faite de métadonnées ObjectStack ordinaires. Son export depuis ObjectOS Cloud ou ObjectOS Enterprise, pour l’exécuter sur le runtime open source ObjectStack, est prévu. Le mapping fait partie de cette ontologie : il voyage avec le paquet.
Commencer par le chemin de l’agent
npm create objectstack@latest crm && cd crmDonnez ensuite à votre agent de code le fichier et la page de documentation des mappings d’import (objectstack.ai/docs/data-modeling/import-mappings), et demandez-lui trois choses : l’objet auquel appartiennent les lignes, un defineMapping dont la valueMap traduit chaque code que le fichier utilise, et un essai à blanc du vrai fichier. Ce qui revient, c’est la revue : un mapping assez court pour être lu d’une traite, et un rapport qui dit combien de lignes seront créées, combien mises à jour, et quelles cellules quelqu’un doit corriger. Signez cela, puis lancez l’import. Relancez-le lundi prochain et lisez updated là où vous l’attendez.