Les vues, les tableaux de bord et les apps sont des projections de l’ontologie : ce que cela change pour la revue
Ajoutez un champ à une app ObjectStack : la table, l’API REST, l’appel describe de MCP et le formulaire de la Console suivent seuls ; les vues, le dataset et la traduction épinglés non. Le test du nom dit lequel est lequel.
Voici le diff entier. Cinq lignes, un champ, ajouté à l’objet todo_task de l’exemple Todo fourni dans le dépôt ObjectStack :
     actual_hours: Field.number({
       label: 'Actual Hours',
       scale: 2,
       min: 0,
     }),
+
+    budget: Field.currency({
+      label: 'Budget',
+      min: 0,
+    }),
Démarrées sur le runtime ObjectStack, ces cinq lignes ont changé la table de la base de données, la lecture et l’écriture REST, l’endpoint de métadonnées, les réponses de describe_object et query_records de MCP et le formulaire de création de la Console : sept surfaces, dont aucune n’a été modifiée. Elles n’ont pas changé les trois vues de liste, le dataset du tableau de bord ni la traduction chinoise, parce que chacune nomme les champs par leur nom. Le premier groupe est dérivé de la définition ; le second y est épinglé. Le test du nom range n’importe quelle projection dans l’un des deux avant que vous l’ouvriez : si elle nomme le champ, vous la relisez ; si elle ne nomme que l’objet, le runtime l’a déjà fait. Le reste de cet article est la mesure derrière cette phrase, prise sur ObjectStack 18.3.0, la version latest sur npm au moment de l’exécution, avec le code de l’exemple au commit 83d7e4ae de cette version, et ce qu’elle change à la lecture d’un diff.
Où vit la définition d’une projection
Trois endroits définissent déjà ce qu’est une projection, et cet article ne les répète pas ; l’essai L’ontologie est le logiciel trace la même ligne comme la première des deux frontières qu’il maintient sur le mot. L’article de définition nomme les quatre projections et donne le test de suppression pour distinguer le noyau d’une projection. La page ontologie énonce la règle en une ligne : changez le noyau et les projections suivent ; retirez une projection et le métier qu’elle montrait est inchangé. L’entrée du glossaire ajoute la conséquence pour un relecteur : un diff qui ne touche que des projections change la présentation, et un diff qui touche le noyau change l’autorité.
Ce qu’aucun ne dit, c’est comment une projection suit. « Suivre » recouvre deux mécanismes différents, et un relecteur doit savoir lequel il a sous les yeux. C’est la question à laquelle répond l’exécution ci-dessous.
L’exécution : un champ, onze lectures
Le point de départ est l’exemple Todo fourni (examples/app-todo), copié hors du dépôt au commit 83d7e4ae (le tag de version @objectstack/cli@18.3.0) et lancé sur les paquets 18.3.0 publiés avec os dev. La base de données est un fichier SQLite local ; la clé d’API a été émise par REST depuis l’administrateur de développement amorcé. Chaque lecture a été prise deux fois : une fois sur la définition committée, une fois après le diff de cinq lignes ci-dessus et un redémarrage avec --compile. « Avant » et « après » sont les deux réponses.
| Surface | Comment elle a été lue | Avant | Après | Suit ? |
|---|---|---|---|---|
Table de base de données todo_task | PRAGMA table_info sur le fichier SQLite | 28 colonnes | 29 ; budget float ajoutée à la table existante | Dérivée |
| Lecture REST | GET /api/v1/data/todo_task | 28 clés par enregistrement | 29 clés | Dérivée |
| Écriture REST | POST /api/v1/data/todo_task avec budget: 1200 | 400 — Unknown field 'budget' on object 'todo_task', code INVALID_FIELD | 201, enregistrement créé | Dérivée |
| Endpoint de métadonnées | GET /api/v1/meta/object/todo_task | 28 champs | 29 ; { label: 'Budget', type: 'currency', min: 0, … } | Dérivée |
MCP describe_object | tools/call sur /api/v1/mcp | 28 champs | 29 | Dérivée |
MCP query_records | where: { budget: { $gte: 1000 } }, fields: ['subject', 'budget'] | — | [["Renew the domain", 1200]] | Dérivée |
| Formulaire de création de la Console | /_console/apps/com.example.todo/todo_task/new | 16 saisies | 17 ; Budget entre Actual Hours et Notes, dans l’ordre de déclaration | Dérivée |
| Détail d’enregistrement de la Console | la page du nouvel enregistrement | — | BUDGET 1,200.00 dans l’onglet Overview | Dérivée |
| Vue de liste de la Console All Tasks | GET /api/v1/meta/view → todo_task.default | 6 colonnes | 6 colonnes, inchangée | Épinglée |
Traduction, zh-CN | GET /api/v1/meta/object/todo_task avec Accept-Language: zh-CN | subject → 主题 | budget → Budget (retombe sur l’anglais) | Épinglée |
Dataset du tableau de bord task_metrics | la définition du dataset | 6 dimensions, 3 mesures, chacune nommant un champ | inchangé ; rien ne peut tracer budget tant qu’une mesure ne le nomme pas | Épinglée |
Deux lectures n’ont pas bougé et ne sont pas des projections : le document OpenAPI liste toujours 17 chemins pour todo_task, sans schéma par champ, et le tools/list de MCP répond toujours les mêmes 12 outils (list_objects, describe_object, validate_expression, query_records, aggregate_records, get_record, create_record, update_record, delete_record, list_actions, run_action, resume_run). Tous deux décrivent des objets, pas des champs ; le champ apparaît dans leurs réponses, pas dans leur forme.
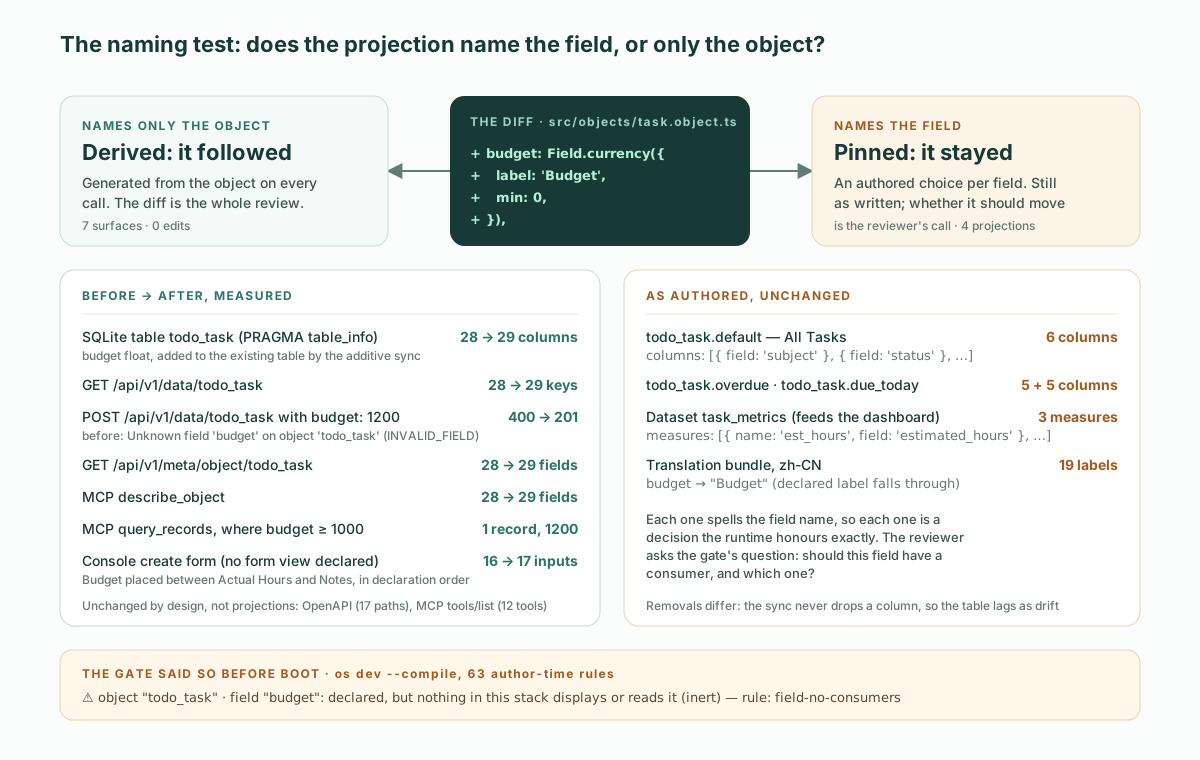
Une lecture de plus est venue gratuitement. os dev --compile exécute les règles de temps d’écriture avant d’écrire l’artefact, et voici ce que la porte a affiché à propos du nouveau champ :
⚠ object "todo_task" · field "budget": declared, but nothing in this stack displays or reads it (inert)
  fix: add it to a view column or a form section, or remove the declaration
  rule: field-no-consumers  at objects[0].fields.budget — `os explain field-no-consumers` for what counts as a consumer
os explain field-no-consumers définit un consommateur comme « a view column, an inline grid column, a form section, a page binding, a flow node, a dataset or cube member, a dashboard widget, a formula, a validation, a hook or an action that names it » (une colonne de vue, une colonne de grille inline, une section de formulaire, un binding de page, un nœud de workflow, un membre de dataset ou de cube, un widget de tableau de bord, une formule, une validation, un hook ou une action qui le nomme) ; le texte de la 18.3.0 compte en outre un groupe de champs déclaré et la clé de correspondance d’un seed ou d’un mapping d’import. Il le distingue d’un porteur, qui « names a field without reading it » (nomme un champ sans le lire), comme « a translation label, a seed value, an import-mapping target, a permission grant » (un libellé de traduction, une valeur de seed, une cible de mapping d’import, une attribution de permission). La liste de la porte est la colonne de droite du tableau. C’est le runtime qui vous dit, avant le démarrage, quelles projections sont épinglées à un champ, et qu’aucune n’a encore repris celui-ci.
Le test du nom
Pourquoi sept surfaces suivent-elles et quatre restent-elles en place ? Pas parce que certaines sont plus importantes. À cause de ce que chacune nomme.
La table, les routes REST, l’endpoint de métadonnées et les outils MCP sont générés à partir de l’objet. La synchronisation de schéma du driver SQL parcourt obj.fields et crée une colonne pour chaque entrée ; les routes de données sont enregistrées par objet et lisent les champs que l’objet possède ; describe_object transpose Object.entries(def.fields) dans sa réponse ; la Console, ne trouvant aucune vue de formulaire déclarée pour todo_task, dispose les propres champs de l’objet. Aucune ne détient une liste de noms de champs. Elles détiennent le nom de l’objet et demandent le reste à la définition à chaque appel, ce qui explique que le champ les ait toutes atteintes sans modification, et dans l’ordre de déclaration.
Les vues de liste, le dataset et le paquet de traduction sont eux aussi des métadonnées écrites, et chacun épelle des noms de champs : columns: [{ field: 'subject' }, { field: 'status' }, …], measures: [{ name: 'est_hours', field: 'estimated_hours', … }], fields: { subject: { label: '主题' }, … }. Une projection qui nomme le champ fait un choix à son sujet — cette colonne, ce libellé, cette agrégation — et le runtime honore ce choix à la lettre. Il n’ajoute pas ce que vous n’avez pas demandé.
Voici donc le test, énoncé pour un relecteur :
Le test du nom. Pour chaque projection que le diff pourrait atteindre, demandez-vous si elle nomme le champ ou seulement l’objet. Si elle ne nomme que l’objet, elle est dérivée : le diff que vous lisez est tout le changement, et le runtime l’a déjà propagé. Si elle nomme le champ, elle est épinglée : elle n’a pas bougé, et c’est à vous de juger si elle aurait dû.
Il se combine avec le test de suppression de l’article de définition. Le test de suppression range une définition dans le noyau ou dans une projection. Le test du nom range les projections qu’un changement du noyau peut atteindre en dérivées et épinglées. À eux deux, un relecteur sait, à partir du seul diff, ce que le runtime a fait et ce qui attend encore une décision.
Ce que cela change à la lecture du diff
La conséquence pratique est un ordre de travail, et il est plus court que celui que suivent la plupart des équipes.
D’abord, la ligne de définition est la revue de chaque surface dérivée. Il n’y a pas de migration de table à lire à côté, pas de sérialiseur, pas de contrôleur, pas de manifeste d’outils. Dans l’exécution ci-dessus, la colonne budget existe parce que le champ existe ; l’écriture REST accepte budget parce que le champ existe ; le describe_object de l’agent l’affiche parce que le champ existe. Si le champ est juste, elles sont justes, et si le champ est faux, elles sont fausses exactement de la même manière que lui. Relire les cinq lignes, c’était relire sept surfaces : c’est la phrase que le titre promettait, et ce que l’entrée du glossaire entend par « un diff qui touche le noyau change l’autorité ».
Ensuite, cherchez le nom du champ dans les projections épinglées, et attendez-vous à ne rien trouver. Un champ ajouté n’apparaîtra dans aucune vue, aucun dataset ni aucune traduction, parce qu’aucun n’a été modifié. Ce n’est pas une omission que le runtime cache ; c’est l’avertissement que la porte a affiché. La question du relecteur est celle que pose la ligne fix: de la porte : ce champ doit-il avoir un consommateur, et lequel ? Pour budget, probablement une colonne dans All Tasks et un libellé zh-CN ; probablement pas encore une mesure de tableau de bord. Ce sont trois modifications petites et délibérées dans trois fichiers nommés, et chacune est aussi relisible que les cinq premières lignes.
Enfin, traitez une suppression comme un autre genre de changement. Tout ce qui précède concerne un champ ajouté. La synchronisation de schéma du driver est uniquement additive : elle crée les tables manquantes et ajoute les colonnes manquantes, et elle ne modifie ni ne supprime jamais celles qui existent, si bien qu’un champ supprimé ou renommé laisse sa colonne derrière lui, comme une dérive que os migrate signale et qu’un humain réconcilie. Les surfaces dérivées suivent une suppression instantanément — l’enregistrement REST perd la clé, describe_object perd le champ — tandis que la table, non. Et chaque projection épinglée qui nomme encore le champ supprimé est désormais fausse, ce que la même porte vous signalera comme un binding pendant. Le test du nom s’applique toujours ; la liste des choses à regarder est simplement plus longue, et elle commence par la migration.
Cet ordre est aussi la moitié manquante de la checklist de revue en quatre passes, dont la quatrième passe est « champs et vues, en dernier ». Le test du nom dit quelles vues : celles qui nomment le champ. Les autres ont été relues en même temps que le champ.
Pour la défense de l’épinglage
Il serait facile de lire la colonne de droite du tableau comme une limite, et la lecture honnête est l’inverse.
Une grille qui ajouterait automatiquement chaque nouvelle colonne réorganiserait un écran chaque fois qu’un développeur ajoute un champ pour qu’un workflow y écrive. Un tableau de bord qui tracerait chaque champ numérique tracerait recurrence_interval. Une traduction qui inventerait des libellés serait une traduction que personne n’a écrite. Les projections épinglées sont épinglées parce qu’un humain a pris une décision de présentation, et un runtime qui la passerait outre en silence serait exactement ce que ce format existe pour empêcher : un comportement que personne n’a déclaré. Le repli de la Console elle-même — disposer tous les champs quand aucune vue de formulaire n’est déclarée — est l’exception qui confirme la règle : il ne s’applique que là où personne n’a encore rien décidé.
Ce que le format donne au relecteur, ce n’est pas que les projections épinglées suivent, mais qu’on peut les trouver. Ce sont des métadonnées dans le même dépôt, elles nomment le champ, et la porte les énumère. L’alternative, dans une base de code écrite à la main, c’est une liste de colonnes dans un composant React, un sérialiseur dans un autre répertoire, un libellé dans un fichier JSON et une configuration de graphique dans un troisième système, sans rien qui sache qu’ils concernent le même champ.
Ce que cela ne couvre pas
Une mesure sur un exemple est une mesure sur un exemple. Quatre choses restent en dehors.
Les vues ajustées à la main restent ajustées à la main. Chaque vue de liste de l’exemple Todo déclare ses colonnes, et chaque vue de l’exemple CRM aussi. Un nouveau champ n’atteint une grille épinglée que si quelqu’un l’y ajoute, et ce quelqu’un est souvent l’agent qui a ajouté le champ, dans la même PR. Le test du nom vous dit de regarder là ; il ne regarde pas à votre place.
Les traductions doivent être écrites. Le runtime retombe sur le libellé déclaré, si bien qu’une entrée zh-CN manquante affiche Budget plutôt que rien. C’est le bon défaut, et c’est quand même un trou qu’un utilisateur chinois voit. Une traduction est une projection épinglée au sens le plus strict : chaque chaîne qu’elle contient est une décision.
Les consommateurs externes sont hors de la stack. La porte le dit elle-même : « a consumer can legitimately live outside the stack — an API client, a hook or package this stack does not carry, a Studio-authored view » (un consommateur peut légitimement vivre hors de la stack : un client d’API, un hook ou un paquet que cette stack ne porte pas, une vue créée dans Studio). Un tableau de bord dans un autre outil qui sélectionne estimated_hours par son nom est épinglé à ce champ, et rien dans le dépôt ne le sait. Le test du nom s’y applique ; l’énumération, non.
Les changements sémantiques ne sont pas des changements structurels. Ajouter un champ est le cas facile, et c’est pourquoi il a été choisi pour un avant-après net. Changez plutôt le sens d’un champ — ajoutez par exemple une option cancelled à status — et les surfaces dérivées suivent tout aussi fidèlement, mais la vue Overdue Tasks de l’exemple Todo et sa métrique Overdue Tasks codent toutes deux le retard comme status != completed, si bien qu’une tâche annulée dont l’échéance est passée compterait comme en retard dans les deux. Le champ déclare bien cette définition une fois — due_date porte dueLike: true, settledWhen: P`record.status == 'completed'` (examples/app-todo/src/objects/task.object.ts, lignes 73–74 en 18.3.0) —, mais la spécification marque les deux clés comme servant uniquement à l’affichage, lues par les cellules de date de la Console, si bien que le filtre de la vue et la métrique énoncent encore la règle chacun de leur côté. C’est une lecture des définitions de la vue, du tableau de bord et de l’objet, pas une mesure, et c’est le genre de conséquence vers laquelle le test du nom vous oriente — toutes trois nomment status — sans décider pour vous.
Pointez votre agent dessus
L’exécution ci-dessus est reproductible depuis le dépôt et prend environ une minute une fois les paquets installés, ce qui veut dire que votre agent peut aussi la faire pour vous. Pointez un agent de code sur un projet ObjectStack — le scaffolder écrit un AGENTS.md et installe le paquet de skills, l’app en marche sert MCP sur /api/v1/mcp, et comment le configurer couvre le fichier de règles, les skills et le serveur d’outils — et quand il ouvre un changement sur un champ, demandez-lui le tableau du test du nom de son propre diff : quelles surfaces ont suivi, quelles projections nomment le champ et ce qu’il propose pour chacune. La ligne field-no-consumers de la porte est la première ligne de ce tableau, et l’agent peut la lire avant vous.
Tout ce qui figure dans cet article a tourné sur la stack open source. « Pour l’exécuter, le dépôt ObjectStack fournit ObjectOS Community — l’image ghcr.io/objectstack-ai/objectstack, os start et la Console, gratuite et auto-hébergée — tandis qu’ObjectOS Cloud est l’édition hébergée et ObjectOS Enterprise l’édition autogérée, sous licence. » Votre ontologie est faite de métadonnées ObjectStack ordinaires. Son export depuis ObjectOS Cloud ou ObjectOS Enterprise, pour l’exécuter sur le runtime open source ObjectStack, est prévu. Le test du nom ne change pas avec l’hôte ; la définition qu’il lit est le même fichier.