Wann sollte man eine ausführbare Geschäftsontologie nicht verwenden?
Fünf Workloads, für die eine ausführbare Geschäftsontologie heute das falsche Werkzeug ist, was stattdessen passt, was die falsche Wahl kostet, und eine Entscheidungstabelle mit Quelle in jeder Zeile.
Kurze Antwort: nicht für fünf Workloads, und die ObjectStack-Dokumentation nennt sie selbst. Das Kern-ERP oder Finanzsystem eines Großunternehmens ersetzen. Arbeit, deren Wert in der Integration vieler bestehender Systeme liegt. Analytik über Data Lakes. Algorithmenlastige Domänen wie Pricing oder Scheduling, es sei denn, der Algorithmus wird als Aktion gekapselt. Und alles, was auf einer zertifizierten Plattform laufen muss. Für jeden Fall gibt es ein besseres Werkzeug, und dieser Beitrag sagt, welches, warum es die richtige Wahl ist und was die falsche Wahl kostet. Am Ende: eine Entscheidungstabelle mit einer Quelle in jeder Zeile und ein Selbsttest mit zehn Fragen, den Sie an Ihrem eigenen Fall durchführen können, bevor Sie irgendetwas installieren.
Eine ehrliche Liste, wo ein Produkt das falsche Werkzeug ist, ist das Nützlichste, was ein Anbieter veröffentlichen kann, denn es ist das eine, was ein Käufer aus dem Vertriebsdeck nicht bekommt. Die einzeilige Positionierung von ObjectStack lautet: „Eine ausführbare Geschäftsontologie. AI schreibt sie, die Runtime führt sie aus, Agents bedienen sie, Sie besitzen sie.“ Alles Folgende handelt von den Rändern dieses Satzes, entnommen der projekteigenen When-to-use-Seite und Vergleichsseite am Tag @objectstack/cli@18.2.0, gelesen am 2026-10-28, sowie der Quelldatei, wo die Grenze eine Codezeile ist. Die Vergleichsseite dieser Website listet die fünf Workloads und die fünf Fragen bereits in je einer Zeile; dieser Beitrag ist die Langform: ein Szenario für jeden Fall, die Alternative und ihre Begründung, die Kosten und der entscheidende Fakt.
Der Sechs-Arten-Test
Ein Test deckt alle fünf Fälle ab, deshalb lohnt es sich, ihn zuerst zu nennen. Die Konzeptseite definiert den Kern einer ausführbaren Geschäftsontologie als sechs Arten von Dingen: Objekte und Felder, Relationen, Aktionen, Berechtigungen, Flows sowie Agent- und Tool-Definitionen. Die Runtime leitet aus diesen sechs die Datenbank, die API, die UI und die Agent-Tools ab und setzt sie bei jedem Aufruf durch. Code verschwindet nicht, aber er wandert in die Runtime, als Hooks, Aktionsrümpfe, CEL und eingeschränktes JSX, innerhalb des Zauns, den die sechs Arten ziehen.
Fragen Sie also bei jedem Workload: Ist der schwierige Teil eine der sechs Arten? Wenn der schwierige, wertvolle, riskante Teil der Arbeit darin besteht, zu entscheiden, was existiert, wie es zusammenhängt, was getan werden darf, von wem, und was wann geschieht, dann ist die Ontologie das Werkzeug, und ein Agent kann sie schreiben. Wenn der schwierige Teil etwas anderes ist, eine gesetzliche Berechnung, eine Verbindung zu vierzig Systemen, ein Scan über ein Petabyte, ein Solver, das Zertifikat eines Auditors, dann ist dieser Teil nicht als Definition ausdrückbar, und die Ontologie kapselt ihn bestenfalls und imitiert ihn schlimmstenfalls. Nennen wir das den Sechs-Arten-Test. Jeder der fünf Workloads unten fällt aus einem anderen Grund durch, und deshalb brauchen sie fünf verschiedene Alternativen statt einer.
1. Das Kern-ERP oder Finanzsystem eines Großunternehmens
Das Szenario. Ein Hersteller mit viertausend Mitarbeitenden betreibt Hauptbuch, Konsolidierung und Lohnabrechnung seit zwölf Jahren auf einem Standard-ERP. Ein Coding-Agent, dem man den Kontenplan zeigt, bietet an, ihn als Objekte neu zu deklarieren, mit Buchungsregeln als Flows und Steuern als Formeln. Die Demo überzeugt: Journale, eine Saldenbilanz, eine Freigabe für jede Buchung.
Was stattdessen, und warum es richtig ist. Das Standardsystem, und darum herum bauen. Die When-to-use-Seite: “A general ledger, consolidation, tax and payroll carry regulation and edge cases that packaged systems already encode. Build around that core, not instead of it.” (Hauptbuch, Konsolidierung, Steuern und Lohnabrechnung tragen Regulierung und Sonderfälle, die Standardsysteme bereits kodieren. Bauen Sie um diesen Kern herum, nicht an seiner Stelle.) In diesem Markt ist die Regulierung das Produkt. Eine Lohnabrechnungs-Engine ist eine Bibliothek von Steuerhoheiten, Meldekalendern und rückwirkenden Korrekturen, gepflegt von Menschen, deren einzige Aufgabe es ist, sie aktuell zu halten; eine Konsolidierungs-Engine ist jahrelange Erfahrung mit Intercompany-Eliminierungen und Sonderfällen der Währungsumrechnung. Nichts davon ist „was existiert und wer was darf“. Es ist Berechnung, und sie ändert sich, wenn eine Regierung sie ändert, nicht wenn Ihr Geschäft es tut.
Die Kosten der falschen Wahl. Ein zweites Hauptbuch. Jede Regel, die Sie neu kodiert haben, ist jetzt Ihr Diff, den Sie pflegen, Ihr Audit, das Sie bestehen, und Ihr Defekt, wenn das Steuerjahr wechselt, während das Standardsystem, das Sie für die gesetzliche Berichterstattung behalten haben, Quartal für Quartal etwas weiter von Ihrer Kopie abweicht. Der Agent, der die Regeln an einem Tag geschrieben hat, kann kein Steuergesetz für Sie lesen.
Der entscheidende Fakt. Die Fähigkeitstabelle der README listet zwölf Dinge, die die Runtime bereitstellt: Objekte und Felder, Berechtigungen, Automatisierung, Freigaben, Views, Dashboards und Reports, Aktionen, APIs und SDK, AI-Tools, Übersetzungen, Seed-Daten, Datenquellen. Ein Hauptbuch, eine Steuer-Engine und ein Lohnlauf stehen nicht darauf, und das Projekt sagt nicht, dass sie kommen.
Was laut derselben Seite passt, ist der Long Tail um diesen Kern: “vendor onboarding, inspections, internal requests” (Lieferanten-Onboarding, Inspektionen, interne Anträge), die Tabellen und Formulare, die nachhalten, was das ERP nicht abdeckt. Jedes davon wird zu einer typisierten Definition statt einer Datei, die per E-Mail herumgereicht wird, und jedes kann die Daten des ERP lesen, ohne sie zu besitzen, was der nächste Fall ist.
2. Workloads, deren Wert in der Integration vieler bestehender Systeme liegt
Das Szenario. Eine Bank möchte, dass ihre Agents eine Kundenfrage aus dem Kernbankensystem, dem CRM, der Kartenplattform und dem Ticketsystem auf einmal beantworten und einen Status in zwei davon zurückschreiben. Keines dieser Systeme wird abgelöst. Die Aufgabe ist, sie für einen Agent lesbar zu machen und über sie hinweg zu handeln.
Was stattdessen, und warum. Eine Schicht über den Systemen: ein Semantic Layer oder Context Layer für das Lesen, eine operative Ontologie nach Art von Palantir, wenn Rückschreibungen zu steuern sind. Die Vergleichsseite räumt das offen ein: “When the data already lives in a warehouse, a lakehouse and a dozen operational systems, these start where you are.” (Wenn die Daten bereits in einem Warehouse, einem Lakehouse und einem Dutzend operativer Systeme liegen, beginnen diese dort, wo Sie sind.) Diese Produkte sind um die Annahme gebaut, dass das System of Record bleibt, wo es ist; ihr Objektmodell ist eine View, ihre Schreibvorgänge sind Writeback, und ihr Wert wächst mit der Zahl der Systeme darunter. ObjectStack ist auf der gegenteiligen Annahme gebaut: dass die Ontologie das System ist und die Datenbank aus ihr abgeleitet wird.
Die Kosten der falschen Wahl. Dies ist der Fall, der am häufigsten falsch entschieden wird, weil die erste Woche gut läuft. ObjectStack kann eine externe Datenbank mit schemaMode: 'external' als Datenquelle föderieren, und ein Lesemodell über einer Legacy-Tabelle ist ein kurzer Nachmittag. Dann kommen die Schreibvorgänge. Föderierte Schreibvorgänge sind standardmäßig doppelt abgeschaltet: Die Datenquelle muss external.allowWrites: true deklarieren und das Objekt external.writable: true, und “with either gate off, insert/update/delete on the federated object is rejected.” (Ist eines der beiden Gates geschlossen, wird insert/update/delete auf dem föderierten Objekt abgewiesen.) Das Gate ist nicht beratend: assertWriteAllowed läuft ganz oben in insert und update der Engine, vor Defaults, Hooks und Validierung. Öffnen Sie beide Gates pro Objekt, und Sie besitzen nun Schreibsemantik gegen ein Schema, das Sie nicht kontrollieren, und schemaMode: 'external' lässt den Boot bei einer Schema-Abweichung fehlschlagen, sodass eine Spaltenumbenennung upstream Ihre App stilllegt. Oder Sie bauen stattdessen Sync-Jobs, und dann haben Sie die Integrationsschicht gebaut, die Sie nicht kaufen wollten, in einem Werkzeug, dessen eigene Dokumentation seine Föderation “early” (früh) nennt.
Der entscheidende Fakt. Zwei Opt-ins, beide standardmäßig aus: allowWrites auf der Datenquelle und writable auf dem Objekt (content/docs/data-modeling/external-datasources.mdx, der Abschnitt über Schreibvorgänge), durchgesetzt von assertWriteAllowed in packages/objectql/src/engine.ts.
Der ehrliche Weg existiert, und er ist schmal: nur lesend anbinden, messen, Schreibvorgänge Objekt für Objekt freischalten, pro Objekt umstellen. How to move an internal system to metadata geht ihn durch, einschließlich der Fälle, in denen die richtige Antwort ist, gar nicht zu migrieren. Dieser Weg ist für ein System, das Sie ersetzen wollen. Wenn Sie vierzig Systeme behalten und über sie hinweg lesen wollen, ist es die falsche Straße.
3. Analytik über Data Lakes
Das Szenario. Ein Händler hat drei Jahre Clickstream- und Kassenereignisse im Objektspeicher, als Parquet- und Iceberg-Tabellen, und das Merchandising-Team will Dashboards. Jemand bemerkt, dass die Plattform Dashboards, Reports und eine Dataset-Schicht hat, die ihre Dokumentation semantisch nennt, und schlägt vor, sie auf den Lake zu richten.
Was stattdessen, und warum. Der Warehouse-Stack: eine Query-Engine für spaltenorientierte Scans, eine Metrik- oder Semantikschicht darüber und ein BI-Tool obenauf. Die Analytik-Schicht in ObjectStack ist eine Metrikschicht für die eigenen Zeilen der Anwendung. Ihre Dokumentation definiert ein Dataset als “a base object, the relationships to include, and the declared dimensions and measures” (ein Basisobjekt, die einzubeziehenden Beziehungen und die deklarierten Dimensionen und Kennzahlen), mit Joins, die aus dem Objektgraphen abgeleitet werden; das Schema macht das wörtlich und beschreibt das object eines Datasets als “Base object name” (Name des Basisobjekts). Die When-to-use-Seite sagt es in einem Satz: Die Analytik-Schicht “defines metrics over the app’s own objects for its reports and dashboards. It is not built to query a lake.” (definiert Metriken über die eigenen Objekte der App für deren Reports und Dashboards. Sie ist nicht dafür gebaut, einen Lake abzufragen.) Ein Warehouse-Semantic-Layer erledigt dieselbe Aufgabe über einem Lake, und die Vergleichsseite dieser Website sagt, dass ein Unternehmen mit ernsthaftem BI weiterhin einen wollen wird.
Die Kosten der falschen Wahl. Eine von zwei Kopien. Entweder laden Sie den Lake in App-Objekte, und haben nun eine zweite Kopie von drei Jahren Ereignissen mit eigener Aktualität und eigener Rechnung, in einem Zeilenspeicher, der aus einer Geschäftsdefinition abgeleitet statt für Scans entworfen ist; oder Sie föderieren eine Warehouse-Tabelle und stellen fest, dass Sie analytische Fragen durch eine Engine schicken, die gebaut ist, um Zeilenabfragen für eine Anwendung zu beantworten, mit Filter-Pushdown und nichts, das eine spaltenorientierte Datei kennt. Die Dashboards werden rendern. Es werden nicht die Dashboards sein, die das Merchandising-Team wollte.
Der entscheidende Fakt. Die Datenquellen, die die README listet, sind PostgreSQL, MySQL, SQLite, MongoDB und In-Memory; das Paketverzeichnis, das die README jetzt an CONTRIBUTING.md abgibt, ergänzt Turso und SQLite in WebAssembly. Es gibt kein Lake-Format, keine spaltenorientierte Engine und keinen Objektspeicher-Treiber, und die Dataset-Schicht bindet an ein Objekt, nicht an eine Tabelle in einem Lake.
4. Algorithmenlastige Domänen wie Pricing oder Scheduling
Das Szenario. Das Produkt eines Logistikunternehmens ist ein Routenoptimierer: ein Solver, der die Aufträge eines Tages und eine Flotte nimmt und einen Plan erzeugt, mit einem Dispositionsboard, auf dem Planer Stopps zwischen Fahrzeugen verschieben und zusehen, wie der Plan neu gelöst wird. Aufträge, Fahrzeuge, Fahrer und Pläne sind offensichtlich Objekte; das Unternehmen fragt, ob das Ganze eine ausführbare Ontologie sein könnte.
Was stattdessen, und warum. Code, für den Solver und für das Board, und hier ist die eigene Dokumentation der Ontologie das stärkste Argument der Gegenseite. Die When-to-use-Seite: Die Ontologie “declares what can be done; it does not express an optimiser.” (deklariert, was getan werden kann; sie drückt keinen Optimierer aus.) Der type einer Aktion ist einer von script, url, modal, flow, api oder form, und der Handler einer script-Aktion ist Code, der mit der vollen Datenautorität der App läuft. Die Definition besitzt die Tür, die Berechtigung an der Tür und das Audit, wer hindurchgegangen ist. Der Algorithmus hinter der Tür gehört Ihnen, in welcher Sprache auch immer ihn löst. Die Oberfläche ist dieselbe Geschichte in die andere Richtung: Die Vergleichsseite sagt, die Console sei “server-driven from metadata, and an interface unlike any business app is easier to build directly.” (servergetrieben aus Metadaten, und eine Oberfläche, die keiner Geschäftsanwendung gleicht, ist direkt leichter zu bauen.)
Die Kosten der falschen Wahl. Den Teil, der zählt, an dem Ort mit der geringsten Freiheit zu bauen. Ein Solver kann hinter einer Aktion leben, und für einen Scheduling-Lauf, der von einem Datensatz ausgelöst wird, ist das genau richtig. Ein Dispositionsboard kann das nicht: Eingeschränktes JSX in Seiten “is parsed into a server-driven UI tree, never executed as code” (wird in einen servergetriebenen UI-Baum geparst, nie als Code ausgeführt), absichtlich, sodass jede Interaktion, die die Planer brauchen, zu einer Verhandlung mit einem Renderer wird, der für Listen, Formulare und Boards gebaut ist. Sechs Monate später ist die Ontologie eine dünne Hülle um das, was Sie tatsächlich verkaufen.
Der entscheidende Fakt. ActionType in packages/spec/src/ui/action.zod.ts ist die geschlossene Menge script | url | modal | flow | api | form. Der Algorithmus ist nie einer davon, nur der Weg zu ihm.
Die Aufteilung, die funktioniert: die Geschäftshälfte, Aufträge, Fahrzeuge, Fahrer, wer einen Plan freigeben darf, was geschieht, wenn ein Plan veröffentlicht wird, als Ontologie, wo ein Agent sie schreiben und bedienen kann; der Solver als Code hinter einer script-Aktion, sodass Berechtigungen, Audit und Agent-Zugriff für ihn gelten wie für jede andere Aktion; das Board der Planer als eigene Anwendung. Wenn das Board das Produkt ist, fangen Sie dort an.
5. Workloads, die eine zertifizierte Plattform erfordern
Das Szenario. Eine Krankenhausgruppe will einen Aufnahme-Workflow, und ihr Einkauf verlangt, dass die Plattform, auf der er läuft, eine bestimmte Attestierung besitzt. Eine öffentliche Ausschreibung stellt dieselbe Frage zu einem ISO-Zertifikat. Der Workload selbst, Formulare, Routing, Freigaben und ein Audit-Trail, passt wie aus dem Lehrbuch.
Was stattdessen, und warum. Entweder eine Plattform, die das Zertifikat besitzt, oder ein Deployment, das Sie selbst zertifizieren, und die Entscheidung ist der Kalender des Käufers, nicht die Roadmap des Anbieters. Die When-to-use-Seite: “ObjectStack is open-source software you deploy and operate, and it carries no compliance certification of its own. Where a workload must run on a certified platform, certifying your deployment is work you own.” (ObjectStack ist Open-Source-Software, die Sie bereitstellen und betreiben, und sie trägt keine eigene Compliance-Zertifizierung. Wo ein Workload auf einer zertifizierten Plattform laufen muss, ist die Zertifizierung Ihres Deployments Arbeit, die Ihnen gehört.) Das ist kein Ausweichen; so funktioniert Zertifizierung. Eine Attestierung deckt eine laufende Umgebung, ihre Kontrollen und ihre Betreiber ab, und ein Apache-2.0-Repository ist nichts davon. Die Sicherheitsseite dieser Website sagt dasselbe über die kommerzielle Edition: “Certification depends on your running deployment, not a binary alone.” (Die Zertifizierung hängt von Ihrem laufenden Deployment ab, nicht von einer Binärdatei allein.)
Die Kosten der falschen Wahl. Das erst beim Einkauf statt beim Entwurf zu entdecken, wenn der Zeitplan bereits annahm, die Plattform bringe ihr Zertifikat mit. Das Audit landet dann auf Ihrem Plan, ohne Budget, kurz vor dem Go-live.
Der entscheidende Fakt. Das Glossar des Projekts führt selbst sein eigenes Protokoll-Konformitätskit als “planned” (geplant), mit “no TCK program or certification mechanism in the codebase today” (heute kein TCK-Programm und kein Zertifizierungsmechanismus in der Codebasis). Es gibt nichts, worauf man einen Auditor verweisen könnte, außer Ihrem Deployment.
Der Workload passt weiterhin; der Host ist die Frage. Die ehrliche Reihenfolge ist, zuerst die Zertifizierungsarbeit zu bepreisen und dann zu entscheiden.
Zwei weitere Stellen, an denen eine andere Kategorie vorne startet
Die Vergleichsseite fügt zwei Zugeständnisse hinzu, die nicht auf der Nicht-passend-Liste stehen, weil sie von einer Art von Problem handeln statt von einer Art von Workload. Beide gehen durch den Sechs-Arten-Test auf dieselbe Weise.
Schließen über heterogene Daten. Wenn die Frage lautet „was folgt aus allem, was wir wissen“, mit Klassenhierarchien, abgeleiteten Fakten und Konsistenzprüfungen über Vokabulare hinweg, dann ist das die Aufgabe einer Wissensontologie, und ObjectStack hat “no object inheritance, no axioms and no reasoner” (keine Objektvererbung, keine Axiome und keinen Reasoner). Der Schlüssel abstract wurde aus der Spezifikation entfernt statt als Versprechen stehen zu bleiben. Die Definition wird validiert, dann ausgeführt; nichts wird zur Laufzeit gefolgert. Der Grundsatzbeitrag behandelt diese Verneinung vollständig.
Reife des Ökosystems. Salesforce, Odoo und ERPNext “bring years of production use, packaged applications, app marketplaces and implementation partners. ObjectStack is younger; expect to build more of it yourself.” (bringen Jahre des Produktiveinsatzes, paketierte Anwendungen, App-Marktplätze und Implementierungspartner mit. ObjectStack ist jünger; rechnen Sie damit, mehr davon selbst zu bauen.) Wenn Sie dieses Quartal eine paketierte App brauchen und einen Implementierungspartner in Ihrer Stadt, ist eine jüngere Plattform die falsche Wette, wie auch immer ihre Definitionen geschrieben sind.
Die Entscheidungstabelle
Jede Zeile: der Workload, ob er heute passt und was stattdessen zu verwenden ist, und der eine Fakt, der es entscheidet, mit seiner Quelle. „Heute“ ist ein Datum: Die Quellen sind objectstack am Tag @objectstack/cli@18.2.0, der Version, die npm view @objectstack/cli dist-tags am 2026-10-28 als latest meldete, an diesem Tag gelesen. Quellen werden nach Datei benannt: when-to-use, compare und ontology sind content/docs/concepts/*.mdx; external-datasources und analytics liegen unter content/docs/data-modeling/; glossary liegt unter content/docs/getting-started/; engine.ts ist packages/objectql/src/engine.ts; dataset.zod.ts und action.zod.ts liegen unter packages/spec/src/ui/; README und CONTRIBUTING.md liegen im Repository-Root.
| Workload | Passt heute? Was stattdessen | Der entscheidende Fakt (Quelle) |
|---|---|---|
| Kern-ERP oder Finanzen eines Großunternehmens | Nein. Das Standardsystem; darum herum bauen | Regulierung und Sonderfälle sind das Produkt; die zwölf Fähigkeiten der Runtime enthalten keine Hauptbuch-, Steuer- oder Lohn-Engine (when-to-use; README-Fähigkeitstabelle) |
| Integration vieler bestehender Systeme | Nein. Ein Semantic oder Context Layer; eine operative Ontologie, wo Writeback stattfindet | Föderation ist standardmäßig doppelt nur lesend: allowWrites auf der Datenquelle und writable auf dem Objekt (external-datasources; assertWriteAllowed in engine.ts) |
| Analytik über einen Data Lake | Nein. Eine Warehouse-Query-Engine, eine Metrikschicht, BI | Ein Dataset bindet an ein Basisobjekt; die Treiber sind Zeilenspeicher, ohne Lake-Format (analytics; dataset.zod.ts; README-Datenquellen; CONTRIBUTING.md-Treiber) |
| Algorithmenlastige Domäne | Nicht für den Algorithmus. Code; hinter einer script-Aktion, wenn der Rest eine Geschäftsanwendung ist | ActionType ist script, url, modal, flow, api, form; der Solver ist nie ein Typ (action.zod.ts; when-to-use) |
| Muss auf einer zertifizierten Plattform laufen | Nicht ohne Arbeit, die Ihnen gehört. Eine zertifizierte Plattform, oder Ihr Deployment zertifizieren | Keine eigene Compliance-Zertifizierung; selbst das Konformitätskit ist „geplant“ (when-to-use; glossary) |
| Schließen über heterogene Daten | Nein. Eine Wissensontologie mit Reasoner | Keine Vererbung, keine Axiome, kein Reasoner; abstract unter ADR-0049 entfernt (ontology; compare) |
| Braucht jetzt ein reifes Ökosystem | Noch nicht. Eine Metadatenplattform mit paketierten Apps und Partnern | „ObjectStack ist jünger; rechnen Sie damit, mehr davon selbst zu bauen“ (compare) |
| Eine neue Geschäftsanwendung: CRM, Ticketing, Freigaben, Operations, interne Tools | Ja. | Objekte, Relationen, Aktionen, Berechtigungen und Flows sind das meiste, was diese Apps sind (when-to-use) |
| Der Long Tail um ein Kern-ERP | Ja. | Klein, spezifisch, ändert sich oft; eine typisierte Definition pro App, die das ERP liest, ohne es zu besitzen (when-to-use) |
| Ein Backoffice, das vom ersten Tag an von Agents bedient wird | Ja. | Jedes Deployment ist ein MCP-Server, standardmäßig an, unter den Berechtigungen des Nutzers (when-to-use; README) |
Führen Sie den Selbsttest durch
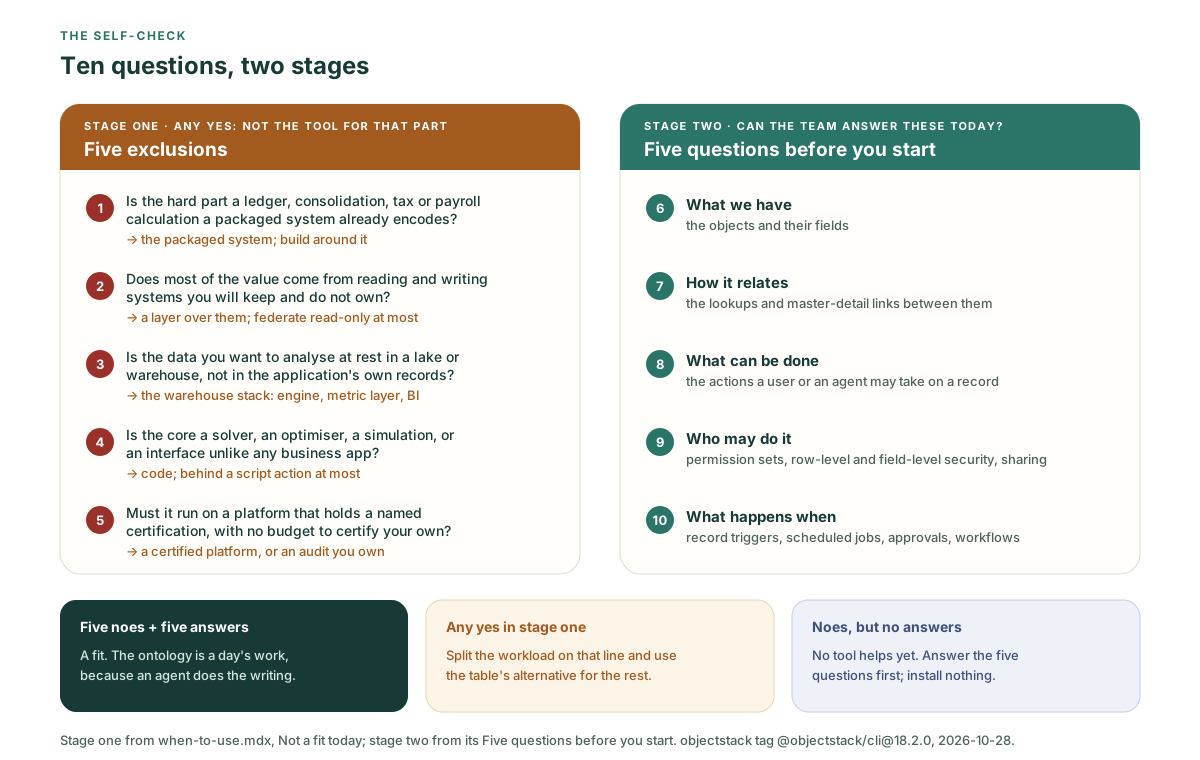
Zehn Fragen, zwei Stufen, zehn Minuten. Stufe eins ist die Ausschlussliste; Stufe zwei sind die “Five questions before you start” (Fünf Fragen, bevor Sie beginnen) der When-to-use-Seite, zitiert, wie sie dort stehen.
Stufe eins. Jedes Ja bedeutet, dass die Ontologie nicht das Werkzeug für diesen Teil ist.
- Ist der schwierige Teil dieses Workloads eine regulierte Berechnung, die ein Standardsystem bereits kodiert: Hauptbuch, Konsolidierung, Steuern, Lohnabrechnung?
- Kommt der größte Teil des Werts aus dem Lesen und Schreiben von Systemen, die Sie behalten und nicht besitzen?
- Ruhen die Daten, die Sie analysieren wollen, in einem Lake oder Warehouse statt in den eigenen Datensätzen der Anwendung?
- Ist der Kern des Produkts ein Solver, ein Optimierer oder eine Simulation, oder eine Oberfläche, die keiner Geschäftsanwendung gleicht?
- Muss der Workload auf einer Plattform laufen, die eine bestimmte Zertifizierung besitzt, ohne Budget, ein eigenes Deployment zu zertifizieren?
Stufe zwei. Kann Ihr Team diese Fragen für das Geschäft heute beantworten?
- “What we have — the objects and their fields.” (Was wir haben: die Objekte und ihre Felder.)
- “How it relates — the lookups and master-detail links between them.” (Wie es zusammenhängt: die Lookups und Master-Detail-Verknüpfungen zwischen ihnen.)
- “What can be done — the actions a user or an agent may take on a record.” (Was getan werden kann: die Aktionen, die ein Nutzer oder ein Agent auf einem Datensatz ausführen darf.)
- “Who may do it — permission sets, row-level and field-level security, sharing.” (Wer es tun darf: Berechtigungssets, Sicherheit auf Zeilen- und Feldebene, Freigabe.)
- “What happens when — record triggers, scheduled jobs, approvals, workflows.” (Was wann geschieht: Datensatz-Trigger, geplante Jobs, Freigaben, Workflows.)
Fünf Nein und fünf Antworten: Die Ontologie ist, in den Worten der Seite, “a day’s work, because an agent does the writing.” (ein Tag Arbeit, weil ein Agent das Schreiben übernimmt.) Fünf Nein und keine Antworten: “no tool helps yet, this one included. The first investment is answering these five questions, not installing anything.” (Noch hilft kein Werkzeug, dieses eingeschlossen. Die erste Investition ist, diese fünf Fragen zu beantworten, nicht irgendetwas zu installieren.) Ein Ja in Stufe eins: Teilen Sie den Workload entlang dieser Linie, behalten Sie den Teil, der bestanden hat, und verwenden Sie für den Rest die Alternative aus der Tabelle.
Was diese Liste nicht sagt
Sie sagt nicht, dass diese Grenzen dauerhaft sind. Die Seite trägt den Titel „not a fit today“ (passt heute nicht), die Föderation wird „early“ (früh) genannt, und die Tabelle oben trägt ein Datum; lesen Sie sie gegen die aktuelle Seite, bevor Sie entscheiden.
Sie sagt nicht, dass die Alternativen im Allgemeinen besser sind. Ein Semantic Layer ist das richtige Werkzeug, um über vierzig Systeme hinweg zu lesen, und das falsche, um einen Ticketdesk zu betreiben, aus den Gründen, die der zweite Abschnitt in die andere Richtung nennt. Die Alternative jeder Zeile ist für diese Zeile richtig.
Und sie sagt nicht, dass das Durchfallen in einer Zeile den Workload durchfallen lässt. Die meisten realen Fälle teilen sich: Der Aufnahme-Workflow passt und der Host ist eine Einkaufsfrage; die Dispositionsdomäne passt und der Solver ist Code; die Abteilungs-Apps um das ERP passen und das Hauptbuch bleibt, wo es ist. Der Sechs-Arten-Test wird auf den schwierigen Teil angewandt, nicht auf den Projektnamen.
Wo ObjectOS in dieser Liste steht
Nichts von dem Obigen ändert sich mit der Edition. ObjectOS gibt es in drei Editionen: ObjectOS Community, quelloffen und kostenlos selbst gehostet; ObjectOS Cloud, gehostet im Browser ohne Installation; und ObjectOS Enterprise, selbst verwaltet auf Ihrer eigenen Infrastruktur. Ihre Ontologie besteht aus gewöhnlichen ObjectStack-Metadaten. Der Export aus ObjectOS Cloud oder ObjectOS Enterprise zur Ausführung auf der quelloffenen ObjectStack Runtime ist geplant. Die fünf Workloads handeln davon, was eine ausführbare Ontologie ausdrücken kann, nicht davon, wo sie läuft, also liest sich die Liste auf jedem Host gleich. Die eine Frage, die den Host betrifft, die Zertifizierung, beantwortet die Sicherheitsseite für ObjectOS in denselben Worten wie die Open-Source-Seite: Sie hängt vom laufenden Deployment ab.
Wenn Ihr Fall bestanden hat
Dann ist der schnellste ehrliche nächste Schritt keine Demo; es ist eine Definition. Richten Sie Ihren Coding-Agent auf ObjectStack, mit der Regeldatei, dem Skills-Bundle und dem Tool-Server, die in how to point your agent at ObjectStack behandelt werden, und bitten Sie ihn um das erste Objekt: ein paar Felder, eine Relation, eine Aktion, ein Berechtigungsset und einen Trigger. Führen Sie npm run validate aus und lesen Sie den Diff, bevor Sie die Console lesen. Wenn Sie den ganzen Diff lesen können und er sagt, was Ihr Geschäft tut, hat der Sechs-Arten-Test in der Praxis bestanden, und was die Definition ist ist die nächste Seite, die Sie dem Agent geben. Wenn nicht, hätte nichts in diesem Beitrag je geholfen, und Sie haben gerade ein Projekt gespart.