Ontología ejecutable vs ontología de conocimiento: por qué «sin herencia, sin axiomas, sin razonador» es lo esencial
Una ontología de conocimiento se construye para razonar sobre ella; una de negocio ejecutable, para validarse y ejecutarse. La prueba es una clave, abstract, que prometió herencia, no hizo nada y fue eliminada, no conservada.
Una ontología de conocimiento se construye para razonar sobre ella. Una ontología de negocio ejecutable se construye para validarse, revisarse y ejecutarse. El README de ObjectStack enuncia la diferencia como tres negativas —«no inheritance, no axioms, no reasoner» (sin herencia, sin axiomas, sin razonador)— y las negativas no son un hueco en una hoja de ruta. Son lo que hace que cada definición sea comprobable y cada diff revisable: una clave que puedes escribir o tiene un lector en el runtime, o se elimina. Este artículo defiende ese argumento por completo, y la prueba es una sola clave.
Aquí está la clave. Un objeto marcado como abstract, tal como puede estarlo una clase en una ontología de conocimiento:
export const Party = ObjectSchema.create({
  name: 'crm_party',
  label: 'Party',
  abstract: true,
  sharingModel: 'private',
  fields: { name: Field.text({ label: 'Name', required: true }) },
});
En @objectstack/spec@15.1.1, publicada el 2026-07-17, esa definición se parsea y abstract vuelve como true. En @objectstack/spec@17.7.0, la versión actual, se rechaza:
Unrecognized key(s) on this object: `abstract`.
  • `abstract` was removed from the spec (ADR-0049) — object inheritance/abstraction is not implemented, so an abstract object still got a table and was instantiable. Remove the key.
No se construyó nada entre medias. No llegó ninguna herencia. Lo que cambió es que una clave que el runtime nunca leyó se sacó de la spec, con un mensaje que dice por qué. Todo lo que sigue es el argumento de por qué eso es lo correcto para un tipo de ontología y sería lo incorrecto para el otro, extraído del README, de la página de conceptos Business Ontology, del registro de decisión que gobierna la eliminación y de los paquetes publicados, medido en lugar de descrito.
Dos ontologías, dos trabajos
La palabra ontología nombra dos objetos distintos en las mismas conversaciones, y el artículo pilar lo listó como la primera de tres cosas que una ontología de negocio ejecutable no es. El párrafo del README sobre el tema es lo bastante corto como para citarlo entero:
Your app’s definition — objects and fields, relations, actions, permissions, flows, and agent and tool definitions — is a business ontology: open, versioned, and yours, not code scattered across a framework. It is executable, not a knowledge-representation ontology: no inheritance, no axioms, no reasoner — validated rather than reasoned over — and it is not a semantic layer over your existing systems (federating an external datasource is read-only by default and early).
— objectstack README.md, “What we mean by ontology”
(En resumen: la definición de tu app —objetos y campos, relaciones, acciones, permisos, flujos, y definiciones de agentes y herramientas— es una ontología de negocio: abierta, versionada y tuya, no código disperso por un framework. Es ejecutable, no una ontología de representación del conocimiento: sin herencia, sin axiomas, sin razonador —validada en lugar de razonada— y no es una capa semántica sobre tus sistemas existentes; federar una fuente de datos externa es de solo lectura por defecto y todavía incipiente.)
Tomemos los dos tipos por turno, y tomemos en serio el primero, porque es el más antiguo y el más riguroso de los dos.
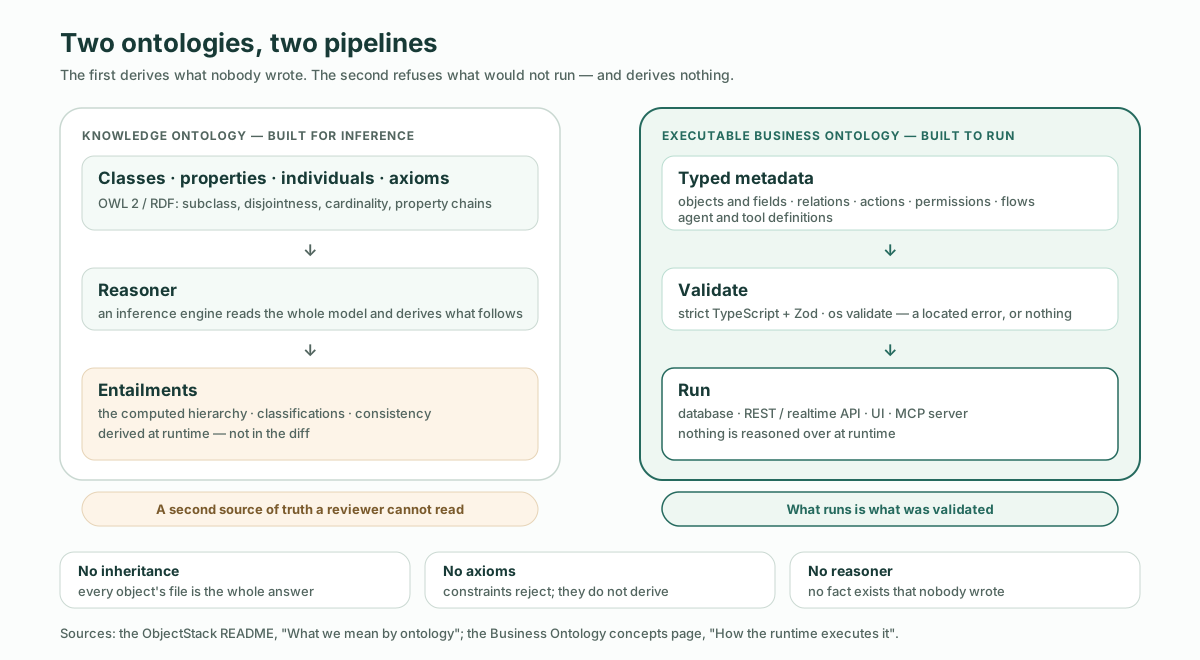
Una ontología de conocimiento se construye para la inferencia. En OWL 2 del W3C y la pila RDF que tiene debajo, escribes clases, propiedades y axiomas: esta clase es subclase de aquella; estas dos clases son disjuntas; esta propiedad tiene como máximo un valor; esta cadena de propiedades implica aquella otra propiedad. Luego un razonador lee el modelo completo y deriva lo que se sigue. La jerarquía de clases se calcula, no solo se declara. Un individuo se clasifica por lo que se sabe de él, no por la clase que alguien tecleó. Las contradicciones entre axiomas se detectan. Y todo funciona bajo el supuesto de mundo abierto: un hecho ausente es desconocido, no falso. Ese es exactamente el diseño correcto cuando los datos vienen de muchas fuentes, el vocabulario tiene que compartirse entre instituciones y la pregunta es «¿qué se sigue de todo lo que sabemos?». La comparación con capas semánticas y grafos de conocimiento hace justicia a esa tradición; este artículo solo necesita su silueta.
Una ontología de negocio ejecutable se construye para que el software pueda generarse, validarse, revisarse y ejecutarse. La página de conceptos da la tubería en una línea:
objectstack.config.ts -> objectstack.json -> ObjectStack runtime -> database · REST / realtime API · UI · MCP servery la regla que la gobierna en otra: «Nothing is reasoned over at runtime: what runs is what was validated.» (Nada se razona en tiempo de ejecución: lo que corre es lo que fue validado.) La definición es la aplicación de un negocio, escrita como metadatos tipados, comprobada por esquemas Zod y por os validate, y después ejecutada. No hay un segundo artefacto de hechos derivados. El mundo está cerrado por construcción: lo que la definición dice es lo que el sistema hace, y lo que no dice, el sistema no lo hace.
| Ontología de conocimiento | Ontología de negocio ejecutable | |
|---|---|---|
| Construida para | Inferencia sobre un dominio descrito | Generar, validar, revisar y ejecutar una aplicación |
| Unidad de definición | Clases, propiedades, individuos, axiomas | Objetos y campos, relaciones, acciones, permisos, flujos, definiciones de agentes y herramientas |
| Qué lee una definición | Un razonador, que deriva implicaciones del modelo completo | Un lector de runtime con nombre por cada clave: el driver de base de datos, la API, el evaluador de permisos, la Console, el servidor MCP |
| Qué existe en tiempo de ejecución sin que nadie lo escribiera | Hechos inferidos: la jerarquía calculada, clasificaciones, consecuencias | Nada. «Lo que corre es lo que fue validado.» |
| Cómo falla una definición incorrecta | Una inconsistencia que el razonador informa, o una implicación que nadie esperaba | Un error localizado en el momento de escribirla, antes de que nada se ejecute |
| Dónde mirar para saber qué hace el sistema | El modelo y lo que implica | El diff |
Las dos columnas no son un ranking. Son dos respuestas a dos preguntas, y la segunda —¿puede un revisor saber qué hace este cambio, y puede un runtime rechazar una definición que no funcionaría?— es la que una aplicación tiene que responder.
Las tres negativas, una por una
Cada negativa quita algo que una ontología de conocimiento hace bien en tener. Cada una está ahí por lo que le costaría a un revisor y a una puerta de validación.
Sin herencia
En una jerarquía de clases, un hijo hereda las restricciones de su padre, y un razonador es lo que te dice el conjunto completo con el que acaba una clase dada. Para un vocabulario eso es una ventaja: declarar el caso general una vez y dejar que el motor lo propague. Para la definición de una aplicación es un coste que paga el lector. Un cambio de una línea en un padre cambia el comportamiento de todos los hijos, ninguno de los cuales aparece en el diff, y la pregunta «¿qué impone realmente este objeto?» no puede responderse desde el propio archivo del objeto.
Los objetos de ObjectStack no heredan. La página de conceptos lista como únicos tipos de enlace entre objetos «Lookups and master-detail links between objects» (lookups y enlaces maestro-detalle entre objetos): relaciones entre registros, declaradas en el objeto que las contiene. La tabla, los campos, los permisos y la postura de seguridad de cada objeto se declaran en ese objeto, así que el archivo es la respuesta completa y el diff es el cambio completo.
Sin axiomas
Un axioma es una restricción que el razonador usa para derivar: de «todo pedido tiene exactamente un cliente» y un pedido con dos, concluye que los dos clientes son el mismo individuo, o que el modelo es inconsistente. Una ontología ejecutable también tiene restricciones —campos obligatorios, opciones de selección, destinos de lookup, predicados CEL, la postura de seguridad que todo objeto debe declarar—, pero se usan para rechazar, no para derivar. La segunda puerta del README es la frase: os validate «rejects metadata that type-checks but would fail silently at runtime: dangling bindings, bad CEL predicates, missing security posture» (rechaza metadatos que pasan la comprobación de tipos pero fallarían en silencio en tiempo de ejecución: enlaces colgantes, predicados CEL incorrectos, postura de seguridad ausente). Una definición que viola una restricción no adquiere una consecuencia. Adquiere un error, con una ubicación.
Sin razonador
Esta es la negativa a la que sirven las otras dos. Un motor de inferencia es una segunda fuente de verdad: los hechos que deriva en tiempo de ejecución nunca se escribieron en ningún sitio donde un revisor pudiera leerlos. «Nothing is reasoned over at runtime: what runs is what was validated» es la regla de la página de conceptos, y su forma práctica es la que dio el artículo pilar: si un permiso no está en el diff, no está en el sistema. El runtime deriva superficies a partir del artefacto —el esquema, la API, la UI, las herramientas MCP— e impone la definición en cada llamada. No concluye nada que la definición no haya dicho.
La prueba: una clave que prometió herencia y no hizo nada
Rechazar un razonador es barato de decir y caro de mantener, porque lo más fácil con una clave que suena a funcionalidad es dejarla en el esquema y dejar que algo, más adelante, le dé un significado. abstract es el aspecto que tiene eso, y el aspecto que tiene lo contrario.
Antes: declarada, parseada, sin leer
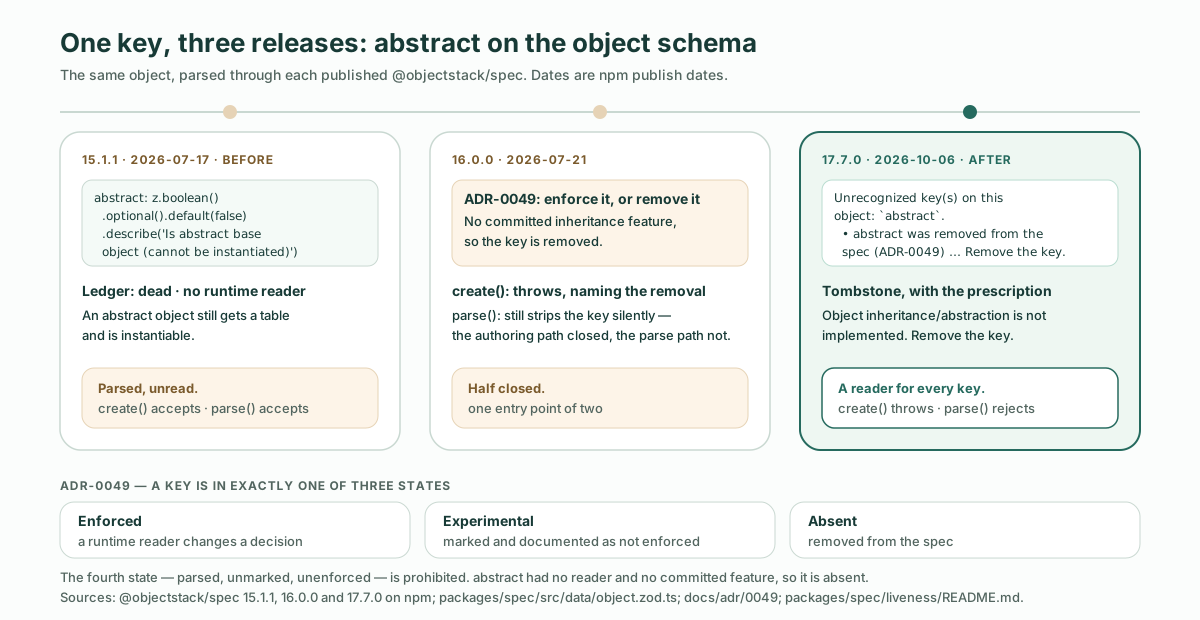
En @objectstack/spec@15.1.1 el esquema de objeto declaraba la clave, con una descripción que es la definición de manual de una clase abstracta:
abstract: z.boolean().optional().default(false).describe("Is abstract base object (cannot be instantiated)")El formulario de objeto del Studio la listaba como campo booleano, con el texto de ayuda «Abstract base (cannot be instantiated)». Y el propio libro de vitalidad (liveness ledger) del mismo paquete —el archivo que el proyecto mantiene para decir, clave por clave, si existe un lector en el runtime— decía esto sobre ella:
"abstract": {
  "status": "dead",
  "evidence": "no runtime reader",
  "authorWarn": true,
  "authorHint": "No runtime reader — an abstract object still gets a table and is instantiable. Object inheritance/abstraction is not implemented."
}
Así que en 15.1.1 la clave se parseaba, el formulario la ofrecía, la salida parseada llevaba abstract: true y —en palabras del libro— un objeto abstracto «still gets a table and is instantiable» (sigue recibiendo una tabla y es instanciable), exactamente como si la línea no estuviera. En una ontología de conocimiento una clase abstracta es una afirmación que el razonador respeta. Aquí era una afirmación que nada respetaba: sintaxis válida, una línea plausible en un diff, y ningún lector.
La regla: impuesta, experimental o ausente
El registro de decisión que gobierna esto es ADR-0049. Se escribió sobre propiedades de seguridad, tras una auditoría que «found that roughly half of all spec properties are dead» (encontró que aproximadamente la mitad de todas las propiedades de la spec están muertas), y enuncia la regla como tres estados:
- Enforced — a runtime consumer reads it and changes a decision (
file:line).
experimental — explicitly marked and documented as not yet enforced, so authoring it is a known no-op (roadmapped, not a promise).- Absent — removed from the spec.
Shipping a security property in a fourth state — parsed, unmarked, unenforced — is prohibited. This is the enforce-or-remove gate.
(En resumen: Impuesta: un consumidor del runtime la lee y cambia una decisión (file:line). experimental: marcada y documentada explícitamente como aún no impuesta, de modo que escribirla es una no-operación conocida (en la hoja de ruta, no una promesa). Ausente: eliminada de la spec. Publicar una propiedad de seguridad en un cuarto estado —parseada, sin marcar, sin imponer— está prohibido. Esta es la puerta impón-o-elimina.)
Su razón es la que importa para cualquier clave, no solo para una de seguridad: «A security property that parses but does nothing is worse than absent: it produces a false sense of compliance.» (Una propiedad de seguridad que se parsea pero no hace nada es peor que ausente: produce una falsa sensación de cumplimiento.) Y su valor por defecto, donde no hay funcionalidad comprometida, es la eliminación: «Removal is preferred over marking when there is no committed roadmap for the property — a smaller spec surface is the stronger default pre-MVP.» (Se prefiere eliminar a marcar cuando no hay una hoja de ruta comprometida para la propiedad; una superficie de spec más pequeña es el valor por defecto más sólido antes del MVP.) abstract no es una clave de seguridad; la propia nota de alcance del ADR registra que el repositorio «cites this ADR as the enforce-or-remove policy for spec-property retirement generally» (cita este ADR como la política impón-o-elimina para el retiro de propiedades de la spec en general), y la orden de trabajo que la retiró, #2377, dice por qué esa generalidad es deliberada: «Authoring them is a false affordance — especially dangerous for AI-authored metadata.» (Escribirlas es una falsa affordance, especialmente peligrosa para metadatos escritos por AI.)
Después: una lápida que te dice qué hacer
La eliminación salió en 16.0.0. El changelog del paquete la registra en una frase: «object tags/active/abstract: ObjectSchema.create() now throws a located error naming the removal. None gated anything at runtime — remove them.» (ObjectSchema.create() ahora lanza un error localizado que nombra la eliminación. Ninguna controlaba nada en tiempo de ejecución: elimínalas.) Hoy la clave es una lápida en la guía de claves desconocidas del esquema de objeto, y el mensaje que verá todo autor que la escriba es el del inicio de este artículo, de object.zod.ts:
abstract:
  '`abstract` was removed from the spec (ADR-0049) — object ' +
  'inheritance/abstraction is not implemented, so an abstract object still ' +
  'got a table and was instantiable. Remove the key.',
La fila de objeto del libro de vitalidad conserva el registro: «tags/active/abstract REMOVED (#2377) — tombstoned in UNKNOWN_KEY_GUIDANCE». El antes y el después se midieron en los paquetes publicados, parseando el objeto Party de arriba con cada uno de ellos:
@objectstack/spec | ObjectSchema.create() | ObjectSchema.safeParse() |
|---|---|---|
| 15.1.1 (2026-07-17) | Acepta; conserva abstract: true | Acepta; conserva abstract: true |
| 16.0.0 (2026-07-21) | Lanza error, nombrando la eliminación | Acepta; elimina abstract en silencio |
| 17.7.0 (2026-10-06) | Lanza error, nombrando la eliminación | Rechaza: unrecognized_keys, con la prescripción |
La fila del medio merece una frase. En 16.0.0 la vía de escritura se cerró y la de parseo no: parse() seguía descartando la clave sin decir palabra, el comportamiento que los propios comentarios del esquema remontan al .strip() por defecto de Zod y a #1535, donde un workflows: [...] a nivel de objeto «vanished with no error, no warning, and a green tsc» (desapareció sin error, sin aviso y con un tsc en verde). El mensaje de 17.x lo dice él mismo, en su última frase: «Until this shape was closed these were dropped silently on the PARSE path — ObjectSchema.create() has rejected them, but defineStack({ objects }), /api/v1/meta/types/object and the Studio form all go through parse(), which did not.» (Hasta que se cerró esta forma, se descartaban en silencio en la vía de PARSE: ObjectSchema.create() las ha rechazado, pero defineStack({ objects }), /api/v1/meta/types/object y el formulario del Studio pasan todos por parse(), que no lo hacía.) Cerrar una clave no es una decisión; es una decisión por cada punto de entrada, y una puerta completa en uno y silenciosa en otro es el cuarto estado con otro abrigo.
Por qué esto es lo esencial
En el momento en que el libro decía «no runtime reader», había dos movimientos honestos. Construir herencia de objetos, para que abstract: true tenga un lector y un significado. O eliminar la clave. El hábito de la ontología de conocimiento —y es un hábito, no un error, en la tradición de la que viene— es conservar la declaración, porque en esa tradición el significado vive en el modelo y el motor lo respetará. El hábito ejecutable es el contrario: el conjunto de claves que puedes escribir es el conjunto de cosas que el runtime hace, y una clave sin lector no es una funcionalidad en espera, es la falsa creencia de un revisor en espera.
Llamemos a eso un lector por cada clave. Es la forma concreta de «validada en lugar de razonada». Un validador solo puede ser completo sobre un vocabulario en el que cada término tiene un consumidor; en cuanto un término se parsea sin leerse, «válido» deja de significar «hará lo que dice». La eliminación de abstract no hizo la ontología más pequeña por el mero hecho de hacerla más pequeña. Mantuvo la promesa de que una definición que pasa la puerta es una definición que el runtime impondrá.
Qué obtiene un revisor, y qué obtiene un agente
Para el humano que revisa un cambio, la recompensa es que el diff es el comportamiento. No hay padre que abrir, ni implicación que calcular, ni clave cuyo efecto dependa de una funcionalidad que puede existir o no. Si sharingModel: 'private' está en el diff, los registros son privados; si un permiso no está en el diff, nadie lo tiene. La pregunta «¿qué hace esta línea?» la responde el lector de runtime que esa línea tiene, y una línea sin lector no puede estar en el diff en absoluto.
Para el agente que escribe el cambio, la recompensa es el mismo hecho visto desde el otro lado. La afirmación del README sobre por qué funcionan los metadatos escritos por AI es que «an agent’s errors become located, corrective text it can read and fix itself» (los errores de un agente se convierten en texto localizado y correctivo que él mismo puede leer y arreglar). Una falsa affordance derrota exactamente eso: un agente que aprende un formato de sus ejemplos no puede distinguir una clave impuesta de una parseada, porque ambas validan, ambas parecen autoritativas y ambas aparecen en las muestras; el fallo que la entrada declarado vs. impuesto describe como declaraciones válidas, plausibles e inertes. Eliminar la clave, y dejar una lápida que termina en «Remove the key.», convierte ese fallo en un arreglo de una línea que el agente puede hacer sin que un humano note que hubo un problema.
En defensa del razonador: lo que esto no hace
Una versión honesta de este argumento tiene que decir a qué renuncia la ontología ejecutable, porque renuncia a cosas reales.
No razona. Sin implicaciones, sin clasificación por descripción, sin comprobación de consistencia a lo largo de un modelo. Si un hecho derivado es el producto que necesitas —«¿cuál de estos diez mil registros es, por lo que sabemos de él, una instancia de contraparte de alto riesgo?»— un razonador lo responde y un validador no.
No hace inferencia de mundo abierto. El mundo cerrado es todo el sentido del diseño, y es el supuesto equivocado para datos que son parciales por naturaleza: un vocabulario compartido entre organizaciones, un registro que es verdadero aunque tu sistema nunca haya visto el hecho que lo hace verdadero. Una ontología de conocimiento está construida para ese caso y esta no.
No hace herencia a nivel de esquema. No hay objeto base. Un campo que comparten seis objetos se declara en seis objetos, o se modela explícitamente como un lookup a uno compartido. La repetición es deliberada —es lo que hace que el archivo de cada objeto sea la respuesta completa— y sigue siendo repetición, con el coste de mantenimiento que la repetición tiene.
No decide que dos cosas son la misma cosa. Que el «cliente» de un sistema y la «cuenta» de otro sean una sola entidad es una declaración que alguien tiene que hacer, no una inferencia que el runtime extrae; el artículo sobre ontología empresarial trata de por qué esa alineación sigue siendo trabajo en cualquier modelo.
Y un límite pertenece a la disciplina misma más que al formato: «validada» solo es tan cierto como lo sean los validadores. La auditoría detrás de ADR-0049 encontró muerta la mitad de las propiedades de la spec antes de que existiera la regla; el libro de vitalidad y las puertas que lo leen son lo que mantiene la regla cierta después, y eso es una tarea de mantenimiento permanente, no un estado que se alcanza una vez. La historia de abstract es prueba de que la disciplina se practica, no de que esté terminada.
Alojado, o en tu propia infraestructura
El README describe este ciclo —un agente escribe metadatos tipados en tu repositorio, la puerta rechaza lo que no funcionaría, el runtime ejecuta lo que pasó— y después dice: «Para ejecutarlo, el repositorio de ObjectStack incluye ObjectOS Community — la imagen ghcr.io/objectstack-ai/objectstack, os start y la Console, gratuita y autoalojada — mientras que ObjectOS Cloud es la edición alojada y ObjectOS Enterprise la autogestionada, con licencia.» Tu ontología son metadatos ordinarios de ObjectStack. La exportación desde ObjectOS Cloud u ObjectOS Enterprise para ejecutarla en el runtime open source de ObjectStack está prevista. La puerta es la misma en cualquier host, y también lo es la ontología que protege.
Prueba el rechazo tú mismo
La vía del agente del README produce el artefacto del que trata este artículo en unos minutos, y el rechazo es la parte que merece la pena ver.
npm create objectstack@latest my-app && cd my-appAbre el proyecto en tu agente de código y describe un objeto de negocio: un cliente, un ticket, una orden de trabajo. Luego pide la línea con la que empezó este artículo: añádele abstract: true, porque va a ser la base de otros objetos. Sea cual sea la puerta que lo alcance primero, la tipada del editor u ObjectSchema.create() en el build, lo rechaza con el mensaje citado arriba, y el mensaje termina en el arreglo. Deja que el agente aplique el arreglo y luego previsualiza el resultado:
npx os dev --ui # → http://localhost:3000/_console/Lo que encontrarás en el diff es un objeto sin base, sin nada heredado y sin ninguna clave que el runtime no lea; es decir, una definición lo bastante pequeña para revisarla y lo bastante estricta para ejecutarla. Si el agente necesita guía, cómo apuntarlo a ObjectStack cubre el archivo de reglas, el paquete de skills y el servidor de herramientas. Las tres negativas del README no son lo que al formato le falta. Son lo que impone.